Noticias IA · RAG Contextual, Embeddings Semánticos y Recuperación de Información Empresarial
Edición: Álvaro MaureiraFecha: 2026-11-02Fuente: Anthropic Engineering & Research
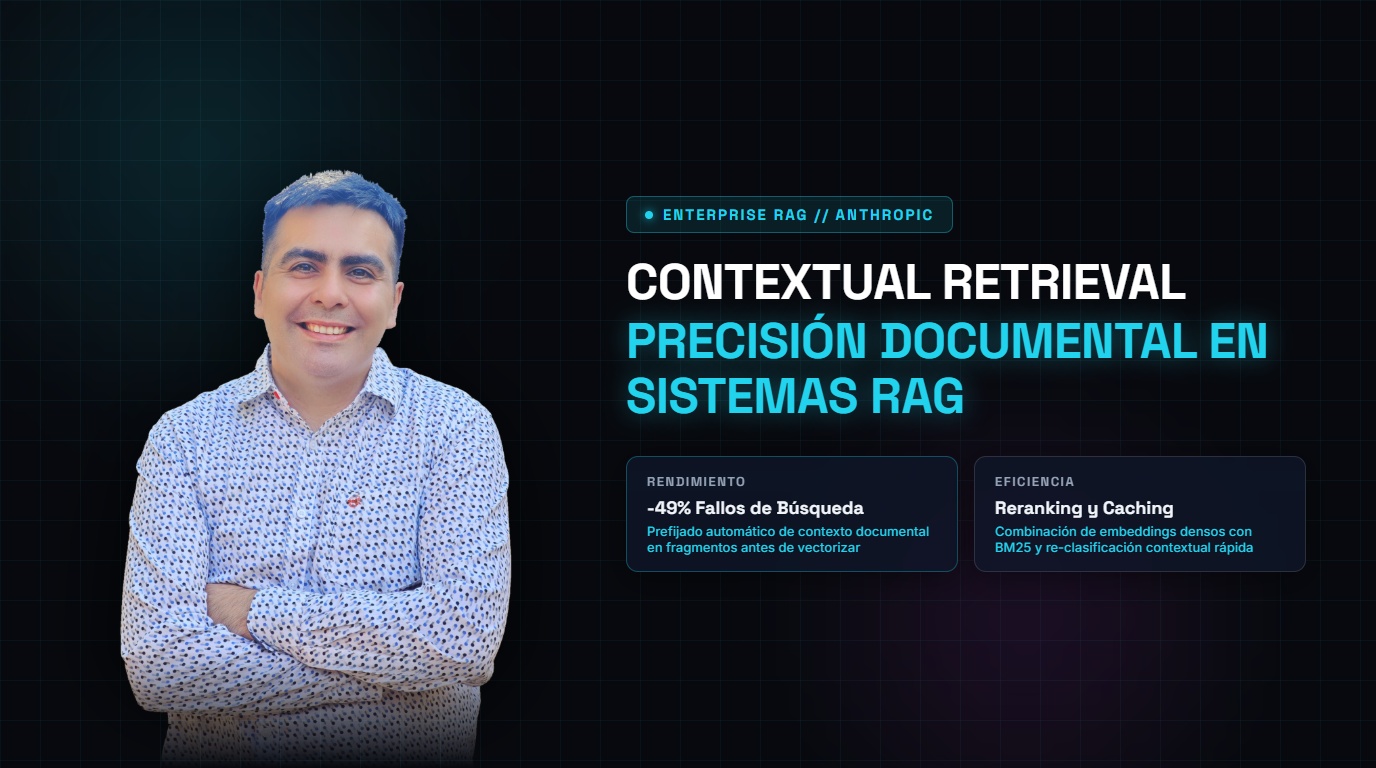
Anthropic presentó Contextual Retrieval, una solución técnica y metodológica diseñada para subsanar el mayor defecto de los sistemas de Generación Aumentada por Recuperación (RAG) en producción: la pérdida de contexto global cuando los documentos corporativos se dividen en fragmentos aislados (chunks). Al utilizar modelos de lenguaje compactos como Claude 3 Haiku y mecanismos de Prompt Caching para prefijar automáticamente a cada fragmento una explicación contextual de 50 a 100 tokens sobre el documento fuente antes de generar sus embeddings, Anthropic demostró una reducción de hasta el 49% en los fallos de recuperación, cifra que asciende al 67% al combinar embeddings semánticos con búsqueda léxica BM25 y re-ranking.
Capítulo 01
La noticia en una frase
Anthropic presentó Contextual Retrieval, método que prefija contexto documental en RAG reduciendo hasta un 49% los fallos de búsqueda.
En evaluaciones empíricas sobre diversas bases de conocimiento corporativas (bases de código, estados financieros, manuales técnicos y contratos legales), Contextual Retrieval redujo los fragmentos irrelevantes recuperados a la mitad, permitiendo a los LLMs downstream responder preguntas complejas sin alucinaciones provocadas por chunks descontextualizados.
Capítulo 02
El alcance que cambia la lectura
El RAG tradicional adolece del problema del 'fragmento huérfano': por ejemplo, una tabla que lista 'ingresos del Q3 de 2024 crecieron un 5%' no menciona en sus 200 caracteres de qué empresa se trata porque el nombre solo figuraba en la portada del informe. Contextual Retrieval inyecta esa procedencia documental de forma sistemática y a escala masiva.
Capítulo 03
El mecanismo documentado
El pipeline toma cada chunk junto con el texto completo del documento y ejecuta un prompt optimizado mediante Prompt Caching para generar una síntesis contextual precisa. Posteriormente, se combinan dos canales: embeddings densos contextuales (para similitud semántica abstracta) y tokens léxicos BM25 contextuales (para palabras clave exactas y códigos de producto), seguidos de un modelo de re-clasificación (re-ranker) que selecciona los 10 mejores resultados.
Capítulo 04
La relación entre las piezas
La metodología puede aplicarse sobre cualquier base de datos vectorial existente (como Pinecone, Weaviate, Qdrant o PostgreSQL con pgvector) y es totalmente agnóstica al modelo de embedding utilizado.
Capítulo 05
Qué capacidad se puede atribuir
Se constata una notable elevación en la precisión de respuesta para preguntas cruzadas que requieren conectar múltiples secciones de un mismo expediente técnico. Sin embargo, no se debe suponer que la técnica compense fallas si los documentos de origen contienen información contradictoria o desactualizada.
Capítulo 06
La puerta de control
Los arquitectos de software pueden ajustar la longitud del prefijo contextual y los umbrales de combinación entre búsqueda semántica y léxica según las necesidades de latencia y presupuesto de cada aplicación.
Capítulo 07
Lo que la fuente no demuestra
Anthropic aclara que generar el contexto documental inicial añade un costo computacional único en la fase de ingestión (aproximadamente 1 dólar por cada millón de tokens procesados con caching), por lo que repositorios con millones de documentos altamente dinámicos deben planificar la estrategia de indexación incremental.
Capítulo 08
Cómo probarlo sin prometer de más
Anthropic publicó la guía de implementación técnica, código de referencia en Python y cuadernos de evaluación en su documentación oficial (`docs.anthropic.com/en/docs/build-with-claude/contextual-retrieval`).
Capítulo 09
Veredicto editorial
Contextual Retrieval soluciona con elegancia ingenieril el talón de Aquiles del RAG corporativo: enriquecer los datos en la ingesta para que los modelos no tengan que adivinar lo que la fragmentación ciega les ocultaba.
Fuente oficial y reporte: Anthropic Engineering & Research