Noticias IA · Hardware de Cómputo, Semiconductores e Infraestructura Cloud
Edición: Álvaro MaureiraFecha: 2026-11-01Fuente: Amazon Web Services Infrastructure & Annapurna Labs
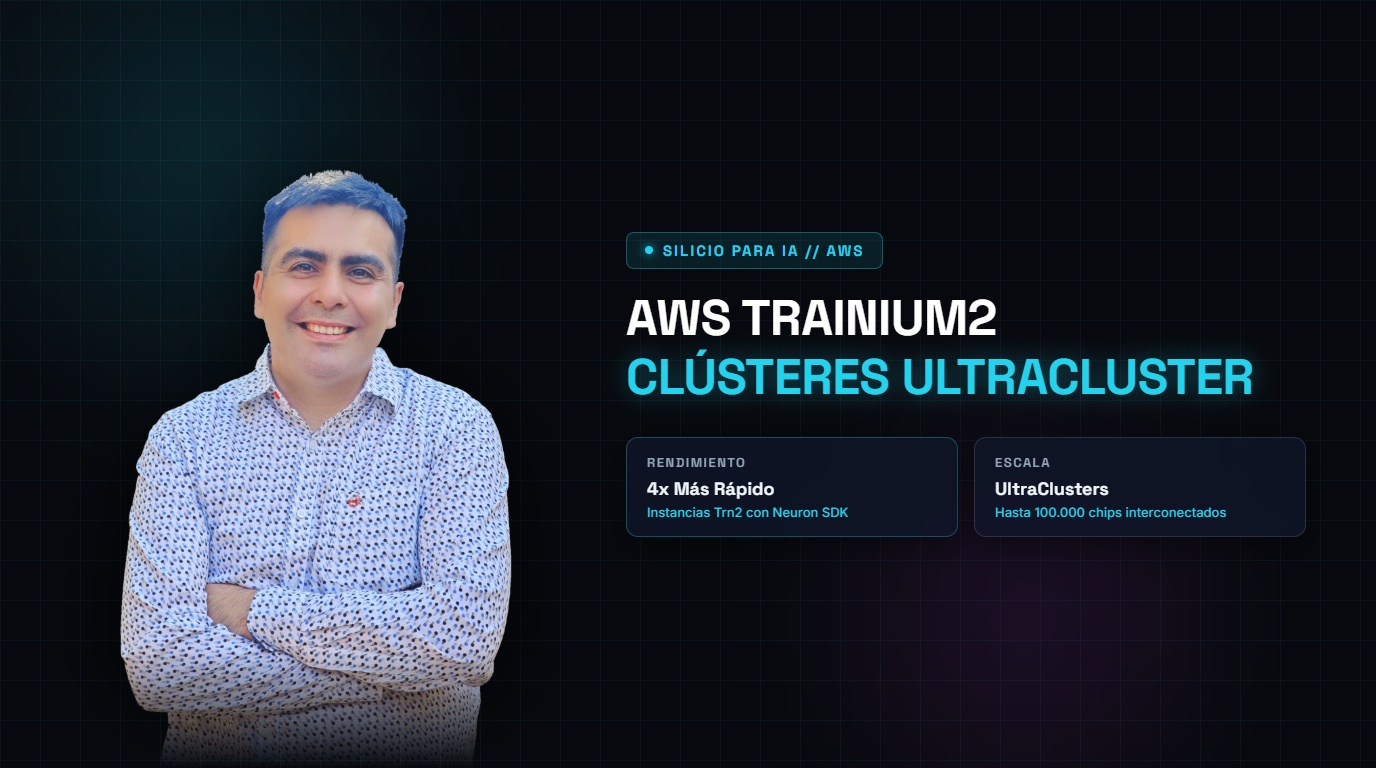
Amazon Web Services (AWS) anunció la disponibilidad general a escala de sus chips Trainium2, la segunda generación de silicio especializado diseñado por Annapurna Labs para el entrenamiento e inferencia masiva de modelos de lenguaje e inteligencia artificial generativa. Diseñados para reducir drásticamente la dependencia del monopolio de GPUs de mercado, los clústeres EC2 UltraClusters con Trainium2 entregan hasta cuatro veces más rendimiento por vatio y un 30% a 40% de reducción de costes de entrenamiento para hiperescaladores y startups.
Capítulo 01
La noticia en una frase
AWS lanzó Trainium2 para entrenamiento de modelos fundacionales con clústeres de hasta 100.000 chips y cuatro veces más rendimiento por vatio.
En noviembre de 2026, AWS desplegó formalmente las instancias `Trn2` y `Trn2 UltraServers`. En colaboración con Anthropic, AWS conectó clústeres de decenas de miles de aceleradores Trainium2 mediante la red interconectada Elastic Fabric Adapter (EFA) de 3.2 Tbps por nodo, entrenando las siguientes iteraciones de la familia Claude con métricas de estabilidad continua de cómputo del 99.8%.
Capítulo 02
El alcance que cambia la lectura
La escasez crónica y los desorbitados precios de adquisición de GPUs convencionales amenazaban con estrangular los presupuestos de I+D de las organizaciones que entrenan modelos propios. Trainium2 rompe este cuello de botella al ofrecer una arquitectura alternativa fabricada a medida para las operaciones matriciales fundamentales de los transformers modernos.
Capítulo 03
El mecanismo documentado
Cada chip Trainium2 incorpora aceleradores de neuronas dedicados con soporte nativo para precisiones numéricas FP8, BF16 y TF32, combinados con memoria de alto ancho de banda (HBM3) de 96 GB por chip y un ancho de banda de memoria de 3.2 TB/s. El software AWS Neuron SDK compila grafos computacionales de PyTorch y JAX directamente a microcódigo optimizado para el silicio sin requerir reescritura de modelos.
Capítulo 04
La relación entre las piezas
Trainium2 se integra de forma transparente con Amazon Bedrock, SageMaker HyperPod y clústeres de almacenamiento Lustre FSx, permitiendo a los equipos de ingeniería aprovisionar miles de aceleradores con plantillas de infraestructura como código (Terraform y CloudFormation).
Capítulo 05
Qué capacidad se puede atribuir
Se comprueba una drástica disminución en el consumo eléctrico por billón de parámetros entrenados y una linealidad casi perfecta en la paralelización de tensor y pipeline en clústeres gigantescos. No obstante, no se debe asumir que cualquier código legacy de CUDA funcionará sin una fase previa de compilación y ajuste mediante el compilador Neuron de AWS.
Capítulo 06
La puerta de control
AWS ofrece aislamiento multi-tenant a nivel de hardware mediante el sistema Nitro, garantizando que los datos de entrenamiento y los pesos de modelos propietarios residan en enclaves criptográficamente seguros y nunca se compartan entre cuentas o regiones de nube.
Capítulo 07
Lo que la fuente no demuestra
La documentación de AWS no demuestra que las herramientas de depuración y perfilado de rendimiento de Neuron hayan alcanzado aún la madurez de ecosistemas con más de quince años de desarrollo continuo como NVIDIA Nsight; la curva de optimización de kernels no convencionales requiere especialización de bajo nivel.
Capítulo 08
Cómo probarlo sin prometer de más
Los equipos de ingeniería pueden solicitar instancias Trn2 a través de la consola de AWS o iniciar pruebas piloto en contenedores Docker Deep Learning Containers preinstalados con Neuron SDK ejecutando scripts de entrenamiento PyTorch convencionales.
Capítulo 09
Veredicto editorial
El despliegue a gran escala de Trainium2 consolida la diversificación imprescindible del ecosistema global de hardware de inteligencia artificial: una infraestructura más eficiente, competitiva y accesible que abarata el entrenamiento de la próxima generación de modelos para toda la industria.
Fuente oficial y reporte: alvaromaureira.cl