C-BRAIN y NVIDIA exploran modelos de IA para investigar el alzhéimer
El consorcio C-BRAIN anunció una nueva fase de investigación que busca construir modelos de inteligencia artificial sobre la biología del alzhéimer, en colaboración con NVIDIA. La iniciativa pretende ayudar a científicos a estudiar datos complejos; no es un diagnóstico, un tratamiento ni una prueba de beneficio clínico para pacientes.
El anuncio del 27 de octubre de 2026 describe un proyecto en desarrollo y dos herramientas de investigación que el consorcio ya ofrece. Conviene distinguir estas piezas: disponer de software para analizar información no significa que el modelo biológico futuro ya exista, ni que sus resultados hayan superado ensayos clínicos.
Por qué importa investigar con mejores datos
La demencia comprende afecciones originadas por distintas enfermedades y lesiones cerebrales. Según la Organización Mundial de la Salud, en 2021 vivían con demencia 57 millones de personas en el mundo, y el alzhéimer representa aproximadamente entre el 60 % y el 70 % de los casos. Son estimaciones de demencia, no un recuento de pacientes tratados por este proyecto.
El desafío para un equipo científico no consiste únicamente en reunir más documentos. También debe identificar qué datos corresponden a cada pregunta, cómo fueron obtenidos y qué limitaciones impiden compararlos. Un hallazgo que parece convincente en una muestra puede cambiar cuando se examina otra población o se revisa el método de medición.
La OMS señala que no existe cura para la demencia, aunque sí hay intervenciones y cuidados que pueden apoyar a las personas y sus cuidadores. La investigación descrita aquí pertenece a una etapa distinta de esa atención: intenta generar y evaluar ideas científicas, no sustituir las decisiones de un equipo sanitario.
Qué anunciaron C-BRAIN y NVIDIA
En su comunicado, el consorcio explicó que quiere desarrollar modelos capaces de aprender aspectos de la enfermedad a partir de datos del cerebro humano y estudiar su evolución. Para ello explora el uso de software de NVIDIA y su experiencia en computación acelerada; el anuncio no presenta un modelo terminado ni resultados clínicos de esa fase futura.
NVIDIA menciona BioNeMo y MONAI como tecnologías consideradas para los flujos de investigación. Incorporar una plataforma de desarrollo o un marco de trabajo no demuestra por sí mismo que un modelo funcione para una población determinada: ese resultado exige describir su entrenamiento, sus pruebas y las condiciones en que podría utilizarse.
La colaboración combina un consorcio de investigación y un proveedor tecnológico, por lo que sus anuncios deben leerse como declaraciones de las partes interesadas. Para medir el impacto real harían falta publicaciones revisables, comparaciones reproducibles y validación por equipos que no dependan exclusivamente de la demostración inicial.
Dos herramientas para preguntas científicas
C-BRAIN identifica OpenScientist e InsightEngine como herramientas actualmente disponibles. La primera recibe una pregunta y datos de investigación para realizar análisis; la segunda relaciona preguntas, literatura y datos con sus fuentes, según el comunicado del consorcio. Son herramientas orientadas al trabajo científico, no aplicaciones presentadas como sustitutos del médico.
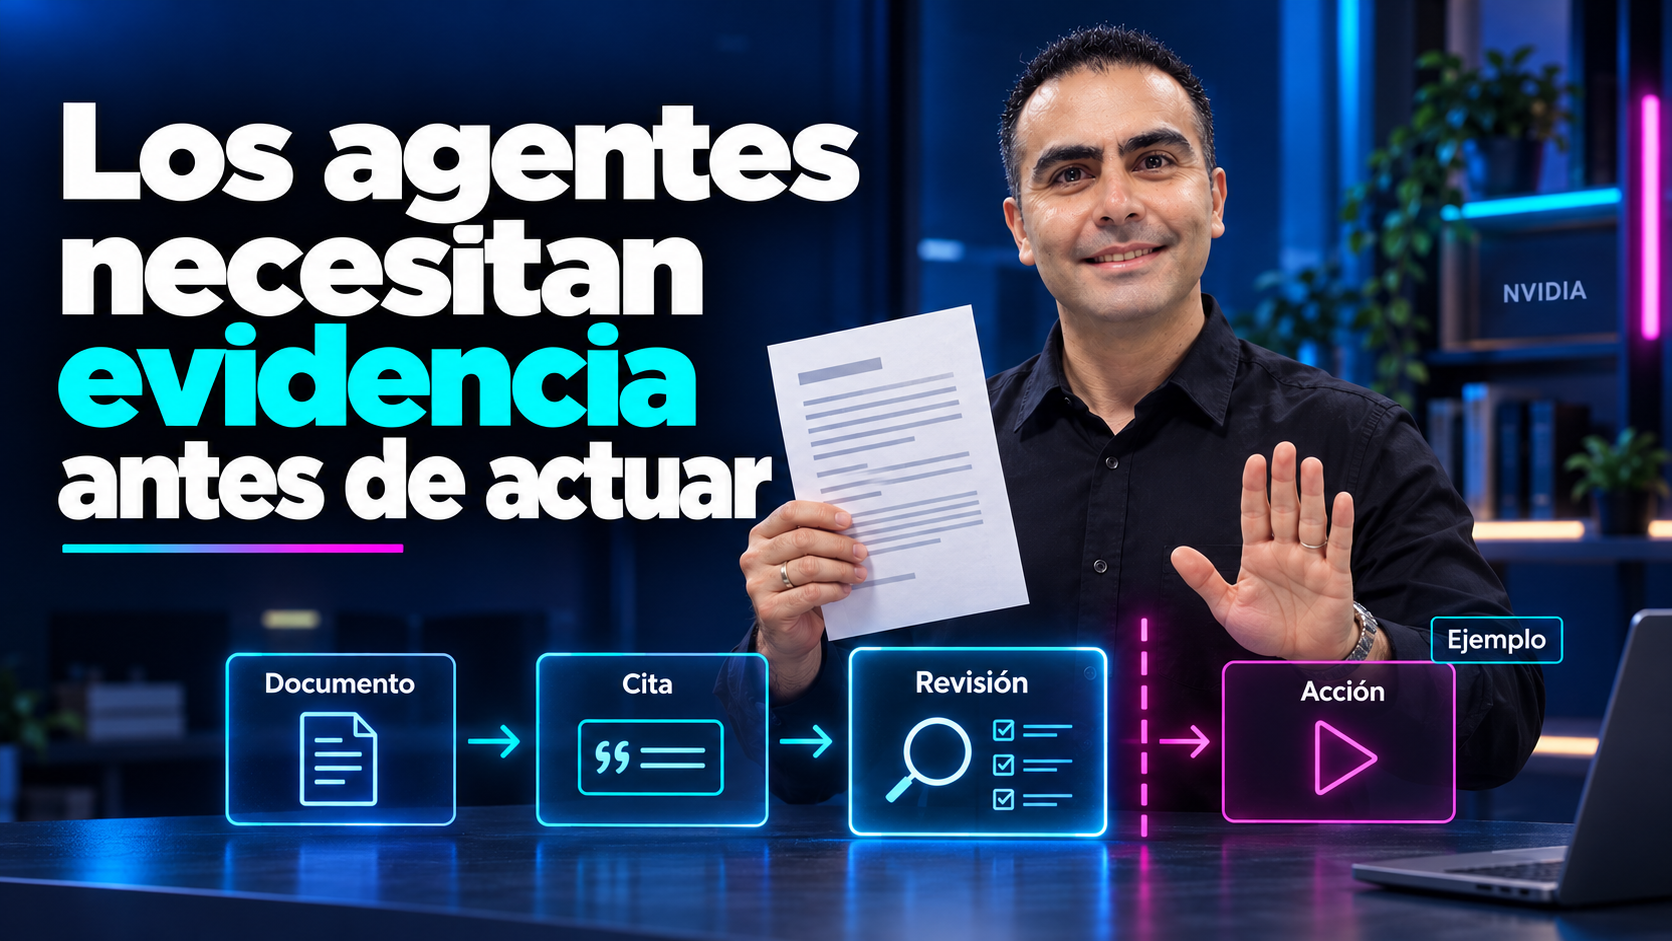
La diferencia importa en la práctica. Una herramienta que organiza evidencia puede ayudar a un equipo a localizar antecedentes y revisar una hipótesis, mientras que un análisis automatizado puede producir resultados que requieren examen estadístico y conocimiento del dominio. En ambos casos, una referencia enlazada facilita revisar una afirmación, pero no garantiza que la interpretación sea correcta.
NVIDIA informa que OpenScientist fue desarrollado junto al Lawrence Berkeley National Laboratory y que InsightEngine se construyó con 387 Labs. La compañía describe estudios de caso en los que algunos análisis se completaron en minutos; no se debe generalizar ese desempeño a cualquier estudio, base de datos o pregunta biomédica.
Datos sensibles y arquitectura distribuida
Según NVIDIA, el consorcio usa un enfoque que combina procesamiento centralizado y federado para trabajar con datos bajo distintas reglas institucionales. En la parte federada, los modelos pueden aprender en cada institución sin que los datos tengan que salir de ella. La empresa informa además de infraestructura local y recursos en la nube.
Mantener datos en su lugar puede reducir algunas necesidades de transferencia, pero no equivale por sí solo a demostrar privacidad completa. Un proyecto responsable debe establecer permisos, finalidad de uso, reglas de acceso, controles sobre resultados y responsabilidades de cada institución. Estas preguntas son especialmente relevantes cuando la información puede estar vinculada con personas.
También importa si los registros son suficientemente representativos. Una colección concentrada en determinados hospitales o grupos puede omitir variaciones relevantes. Antes de trasladar una conclusión a otros contextos, los investigadores necesitan conocer la procedencia de los datos, sus lagunas y cómo se verificó el resultado fuera de la muestra original.
De una hipótesis a evidencia útil
Un sistema puede encontrar asociaciones o formular hipótesis más rápido que una revisión manual, pero una asociación no establece por sí sola una causa. Para pasar de una señal computacional a una conclusión sólida se necesita un diseño adecuado, evaluación independiente y, cuando corresponda, estudios posteriores que comprueben sus implicaciones.
El consorcio plantea como objetivo posterior construir modelos que aprendan de datos biológicos a distintas escalas. NVIDIA menciona modalidades como imágenes y medidas clínicas longitudinales entre sus planes. Son objetivos de investigación, no una descripción de resultados ya demostrados ni una promesa de disponibilidad para hospitales.
La utilidad también depende de la trazabilidad: un investigador debería poder examinar los datos autorizados, las versiones del software, los pasos del análisis y las fuentes que sustentan cada conclusión. Sin esa información, una respuesta rápida puede ser difícil de reproducir o corregir, incluso cuando parece plausible.
Qué conviene seguir a partir de ahora
El próximo punto de evaluación será la evidencia específica que publiquen los equipos: qué tareas se probaron, con qué conjuntos de datos, frente a qué alternativas y bajo qué medidas de calidad. Las estimaciones de tiempo o costo deben acompañarse de su metodología y no reemplazan una evaluación de precisión.
Para instituciones interesadas, el acceso a una herramienta, el acceso a datos sensibles y el permiso para emplear resultados en atención sanitaria son cuestiones diferentes. Cada una requiere revisar condiciones y responsabilidades. El anuncio consultado no establece disponibilidad clínica en Chile ni autoriza una conclusión sobre eficacia en pacientes.
Preguntas frecuentes
¿Esto es una cura o un sistema de diagnóstico?
No. El anuncio describe investigación y herramientas para científicos. No presenta una cura ni prueba que estas herramientas puedan diagnosticar o tratar a una persona.
¿El nuevo modelo biológico ya está terminado?
El comunicado lo presenta como una fase de construcción y exploración futura. Las herramientas de investigación mencionadas son distintas de ese objetivo.
¿Puede la IA demostrar por sí sola una causa?
Una señal en datos puede orientar preguntas, pero demostrar causalidad requiere métodos y evidencia adecuados. La salida de un modelo debe poder contrastarse y revisarse.
¿Los datos federados son automáticamente privados?
No se puede concluir eso solo por la arquitectura. La protección depende también de permisos, controles, condiciones de uso y evaluación del sistema concreto.
Fuentes: comunicado de C-BRAIN, NVIDIA y Organización Mundial de la Salud.