Noticias IA · Modelos de Voz Expresiva, Spirit LM y Multimodalidad Intercalada
Edición: Álvaro MaureiraFecha: 2026-11-02Fuente: Meta Fundamental AI Research (FAIR)
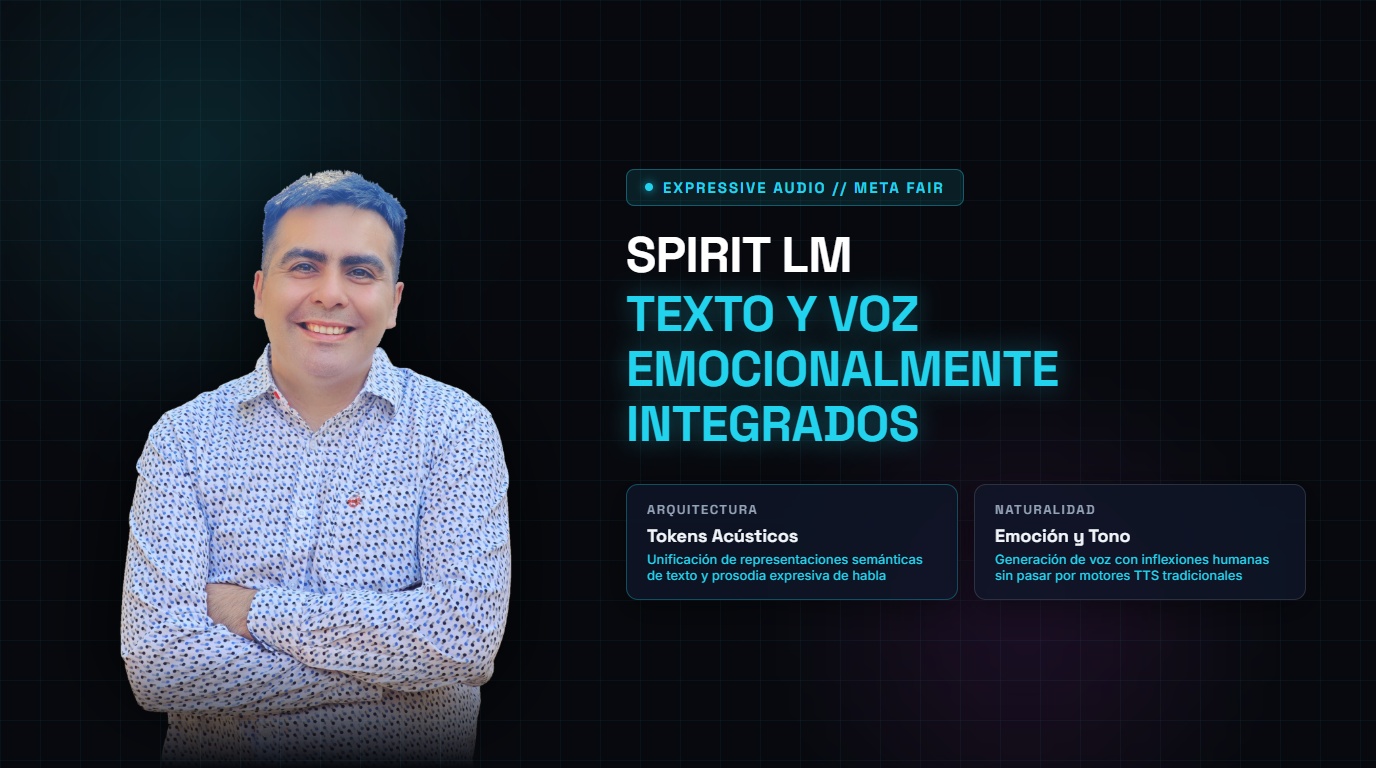
Meta Fundamental AI Research (FAIR) presentó Spirit LM, su primer modelo fundacional autoregresivo capaz de procesar y generar texto y voz de forma totalmente intercalada y nativa. A diferencia de las arquitecturas tradicionales basadas en canalizaciones secuenciales (ASR para transcribir, LLM para razonar y TTS para sintetizar), Spirit LM elimina la pérdida de información paralingüística entrenándose directamente sobre tokens semánticos de texto y tokens acústicos continuos de habla. El modelo captura no solo el contenido literal del mensaje, sino el tono emocional, la velocidad elocutiva, las pausas prosódicas y la emoción intrínseca de los interlocutores humanos.
Capítulo 01
La noticia en una frase
Meta presentó Spirit LM, modelo fundacional que combina texto y voz intercalados con entonación, timbre y prosodia emocional.
En pruebas de evaluación humana y acústica objetiva, Spirit LM demostró una capacidad sobresaliente para reproducir y responder con emociones congruentes (como alegría, enfado, sorpresa o neutralidad profesional) en conversaciones fluidas, superando con creces la naturalidad percibida de los sistemas TTS en cascada y preservando el estilo expresivo a través de cambios de idioma.
Capítulo 02
El alcance que cambia la lectura
Hasta ahora, la computación conversacional ha operado bajo una simplificación severa: convertir el habla humana en texto plano, perdiendo en el camino más del cincuenta por ciento de la información comunicativa, como el sarcasmo, la duda o la urgencia. Spirit LM demuestra que los modelos fundacionales pueden unificar la inteligencia lingüística y acústica en un único sustrato neuronal.
Capítulo 03
El mecanismo documentado
Spirit LM se presenta en dos variantes: Spirit LM Base, optimizado con tokens acústicos de tono y ritmo para síntesis fluida; y Spirit LM Expressive, que integra un cuantizador vectorial entrenado para capturar clusters emocionales y variaciones prosódicas sutiles. La arquitectura utiliza un tokenizador multimodal unificado que procesa entradas mixtas (secuencias donde fragmentos de voz y texto se alternan libremente en el mismo contexto).
Capítulo 04
La relación entre las piezas
El proyecto fue publicado bajo licencia de investigación comunitaria, liberando tanto los pesos de los modelos como el código fuente y las herramientas de evaluación para permitir a la comunidad académica explorar la interacción humano-máquina empática.
Capítulo 05
Qué capacidad se puede atribuir
Se constata una notable competencia para adaptar dinámicamente el tono de la voz generada en respuesta a la carga afectiva del interlocutor, así como para alternar entre modalidades de entrada y salida sin descalibrar el hilo lógico del diálogo. Sin embargo, no se debe atribuir al sistema introspección afectiva real o comprensión consciente de emociones humanas.
Capítulo 06
La puerta de control
Los desarrolladores pueden condicionar explícitamente los tokens de control emocional al inicio del flujo generativo para imponer límites estrictos de neutralidad o formalidad cuando el modelo opere en entornos de atención médica o financiera.
Capítulo 07
Lo que la fuente no demuestra
Meta recalca que Spirit LM todavía presenta desafíos en la pronunciación precisa de nombres propios extranjeros infrecuentes y en entornos con ruido de fondo extremo donde los tokens acústicos pueden degradar la fidelidad semántica.
Capítulo 08
Cómo probarlo sin prometer de más
El código del modelo, las muestras de audio comparativas y los pesos para investigación están disponibles en el portal oficial de investigación de Meta AI y en Hugging Face (`facebookresearch/spirit-lm`).
Capítulo 09
Veredicto editorial
Spirit LM marca un hito en la humanización de las interfaces vocales: una confirmación indiscutible de que el futuro del audio digital no es transcribir para entender, sino escuchar y hablar comprendiendo el matiz expresivo de cada fonema.
Fuente oficial y reporte: Meta Fundamental AI Research (FAIR)