
Investigadores del MIT HAN Lab presentaron SmoothQuant, un método de cuantización de 8 bits para pesos y activaciones (W8A8) sin pérdida de precisión que traslada la dificultad analítica de las activaciones hacia las matrices de pesos, permitiendo servir modelos de hasta 175.000 millone
Sigue leyendo las noticias clave de IA
Filtrar y personalizar
 MIT HAN Lab Presenta AWQ: Cuantización a 4 Bits Guiada por Activaciones para Acelerar la Inferencia de LLMsMIT HAN Lab libera AWQ, técnica de cuantización a 4 bits guiada por activaciones que acelera la inferencia de LLMs hasta 3x sin pérdida de precisión.Leer análisis completo
 InstructMesh propone corregir modelos 3D antes de fabricarlos mediante lenguaje y edición localInvestigadores de MIT y Google presentan InstructMesh: edición dirigida de mallas generadas por IA para resolver defectos mecánicos antes de imprimir en 3D.Leer análisis completo
 MIT ajusta pronósticos para dos a seis semanasMIT explica una corrección de pronósticos para dos a seis semanas. Un ejercicio distingue probabilidades, decisiones reversibles y límites.Leer análisis completo
 Microsoft Detalla BitNet b1.58: Inferencia Eficiente de LLMs con Ponderaciones Ternarias a 1 BitMicrosoft presenta BitNet b1.58, arquitectura donde cada parámetro adopta valores ternarios {-1, 0, 1}, reduciendo el consumo energético en inferencia de LLMs.Leer análisis completo
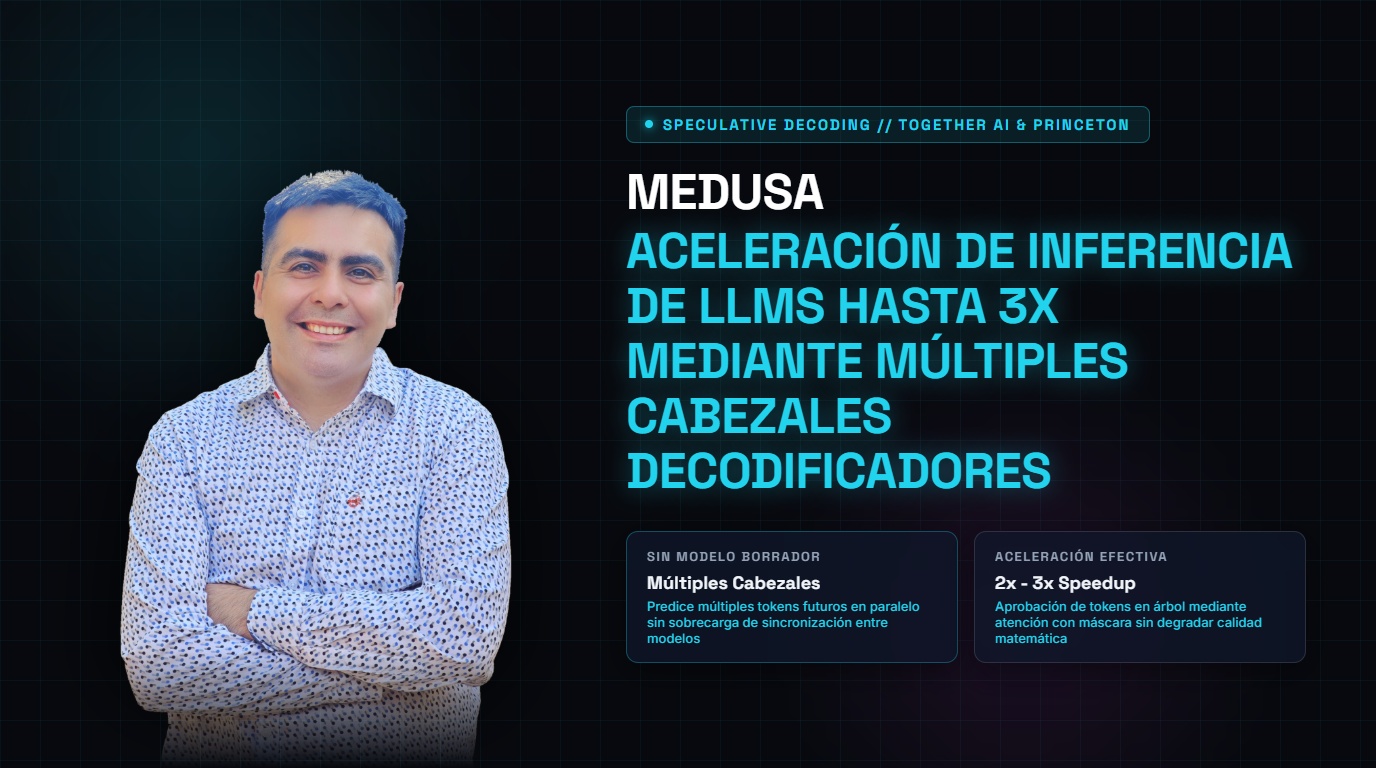 Together AI y Princeton Presentan Medusa: Muestreo Especulativo con Múltiples Cabezales para Acelerar LLMs hasta 3xTogether AI y Princeton presentan Medusa, marco de decodificación especulativa con múltiples cabezales que acelera la inferencia de LLMs hasta 3x sin borrador.Leer análisis completo
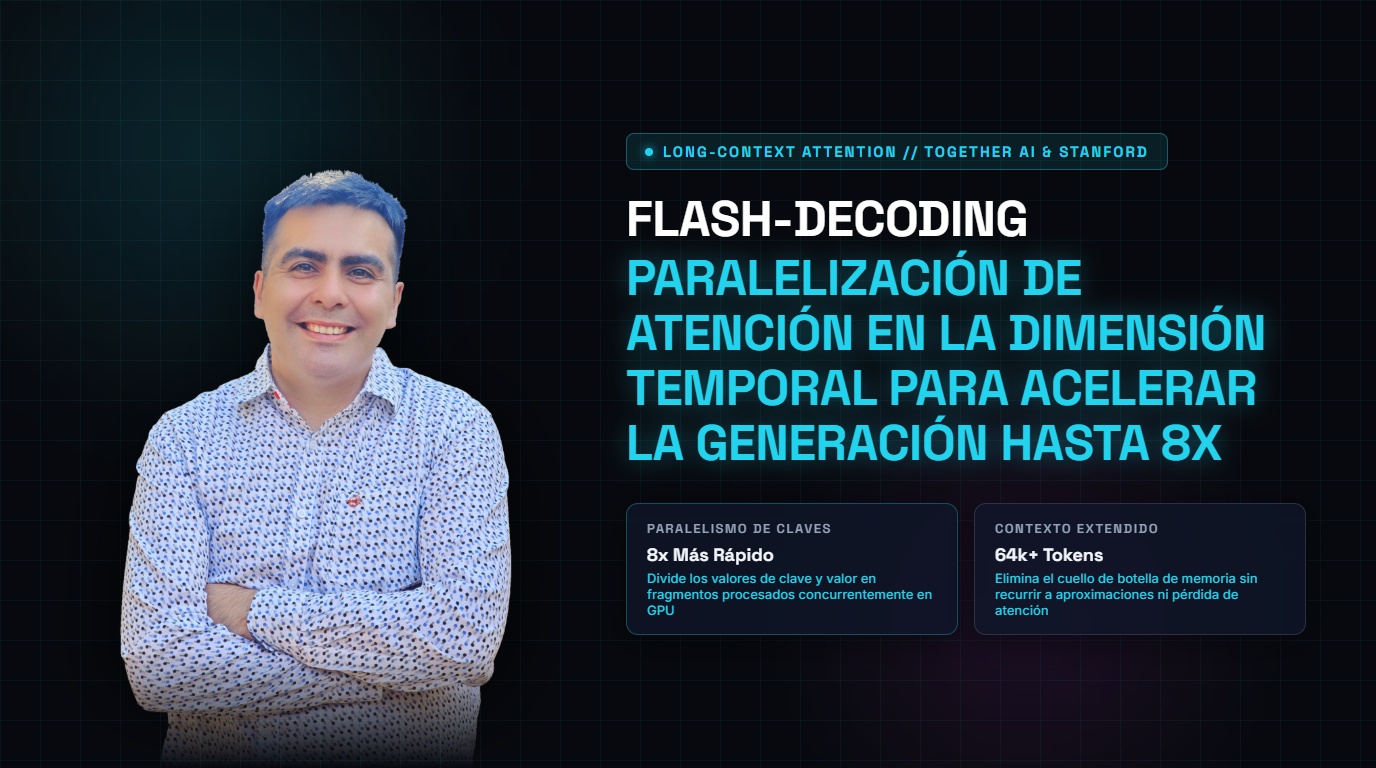 Together AI y Stanford Presentan Flash-Decoding: Aceleración de Generación de LLMs hasta 8x en Contextos LargosTogether AI y Stanford presentan Flash-Decoding, técnica que paraleliza la atención en secuencias largas acelerando la generación de LLMs hasta 8x en GPUs.Leer análisis completo
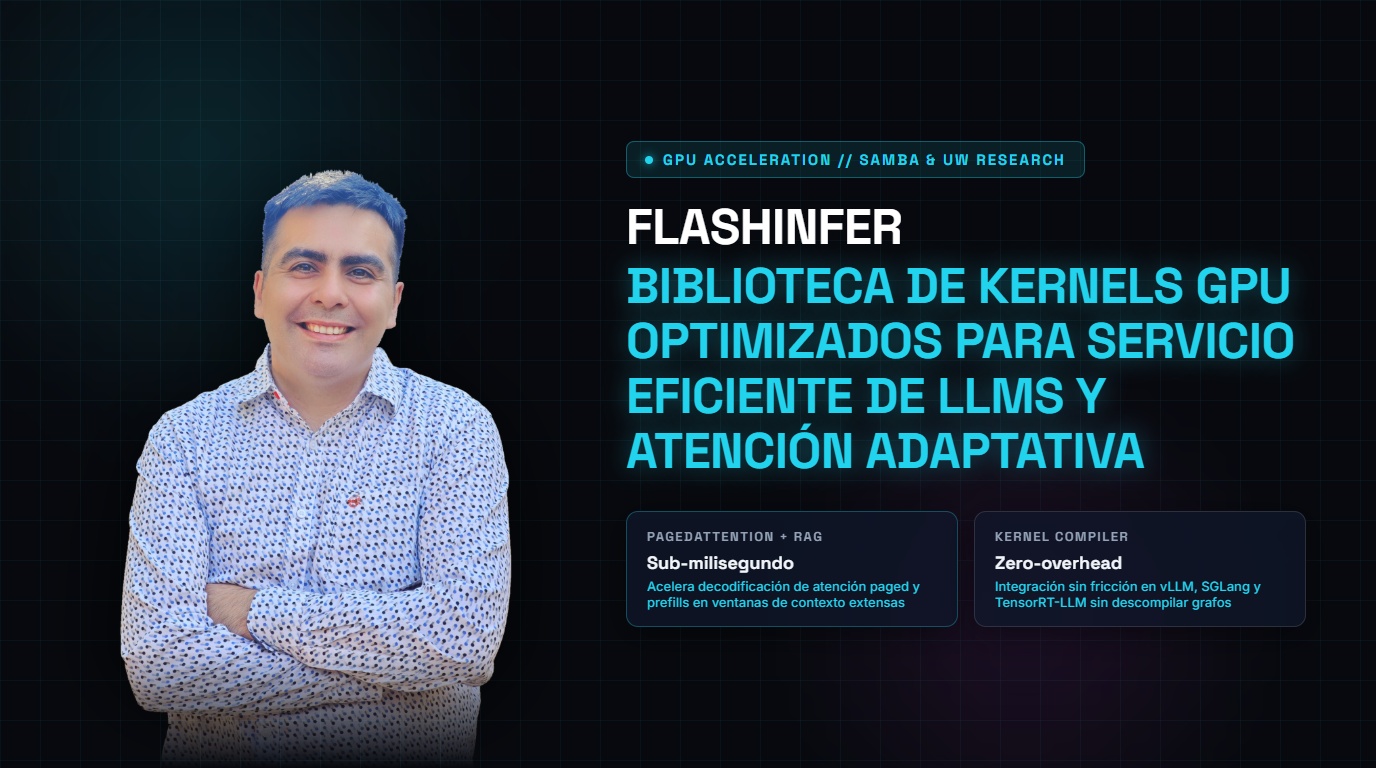 University of Washington Presenta FlashInfer: Biblioteca de Kernels GPU Acelerados para Servicio Eficiente de LLMsUW y SambaNova presentan FlashInfer, suite de kernels CUDA optimizados para atención paginada y aceleración de inferencia de LLMs con cero sobrecarga.Leer análisis completo
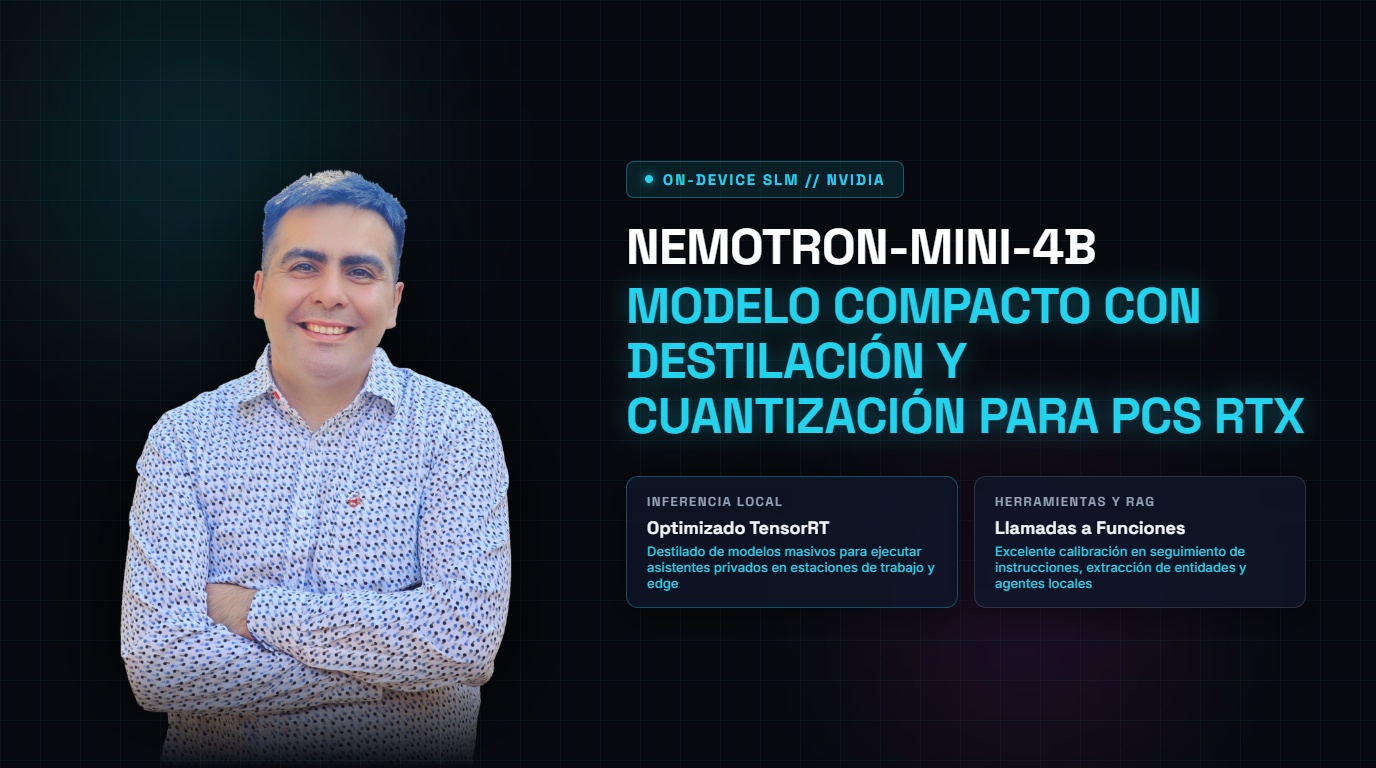 NVIDIA Presenta Nemotron-Mini-4B-Instruct: Modelo Compacto Optimizado con Destilación y Cuantización para Inferencia On-DeviceNVIDIA lanza Nemotron-Mini-4B-Instruct, SLM optimizado para PCs con IA y entornos edge con alta precisión en llamadas a funciones y razonamiento estructurado.Leer análisis completo
 LMSYS y UC Berkeley Presentan SGLang: Servicio de LLMs con RadixAttention y Rendimiento hasta 5xLMSYS y UC Berkeley presentan SGLang, marco de ejecución estructurada y servicio de LLMs con RadixAttention que multiplica el rendimiento hasta 5x.Leer análisis completo
 Shanghai AI Lab Presenta InternLM 2.5: Modelos Abiertos de Razonamiento con Ventana de Contexto de 1 Millón de TokensShanghai AI Lab lanza InternLM 2.5 en 7B y 20B, con procesamiento de 1M de tokens, razonamiento matemático avanzado y llamadas a herramientas complejas.Leer análisis completo
 Meta FAIR presenta Open Materials 2026: modelos de grafos cristalinos para acelerar el descubrimiento de catalizadores y captura de carbonoMeta FAIR liberó Open Materials 2026 con modelos de grafos cristalinos para acelerar el diseño de catalizadores y la captura de carbono.Leer análisis completo
 Hugging Face Presenta Distil-Whisper: Destilación de Modelos de Voz con 6x Mayor Velocidad y Paridad de PrecisiónHugging Face presenta Distil-Whisper, reduciendo la latencia de Whisper en 6 veces y el tamaño en un 49% con paridad de precisión en transcripción de voz.Leer análisis completo
 Apple Presenta OpenELM: Familia de Modelos de Lenguaje Ultraligeros de Código Abierto Optimizados para Inferencia en el BordeApple lanza OpenELM (270M a 3B parámetros), modelos de lenguaje de código abierto con escalado no uniforme para inferencia eficiente on-device.Leer análisis completo
 Shanghai AI Lab Presenta InternLM-XComposer 2.5: Modelo Multimodal Abierto para Comprensión Visual y Composición de ArtículosShanghai AI Lab presenta InternLM-XComposer 2.5, modelo multimodal de 7B capaz de generar artículos extensos ilustrados y comprender video y alta resolución.Leer análisis completo
 Cerebras despliega CS-3 con Wafer Scale Engine 3: el procesador monolítico que supera los 1.800 tokens por segundo en inferencia de LLMsCerebras activó CS-3 con el procesador gigante WSE-3, logrando más de 1.800 tokens por segundo en inferencia para agentes conversacionales.Leer análisis completo
 IBM Presenta Granite Guardian: Modelos Abiertos Especializados en Detección de Riesgos, Sesgos y Seguridad para LLMsIBM lanza Granite Guardian, modelos abiertos especializados en detección de riesgos, sesgos, alucinaciones y seguridad para pipelines de LLMs empresariales.Leer análisis completo