Noticias IA · Evaluación de Modelos, Benchmarks Libres de Contaminación y Seguridad
Edición: Álvaro MaureiraFecha: 2026-11-02Fuente: Scale AI Safety, Evaluations and Alignment Lab (SEAL)
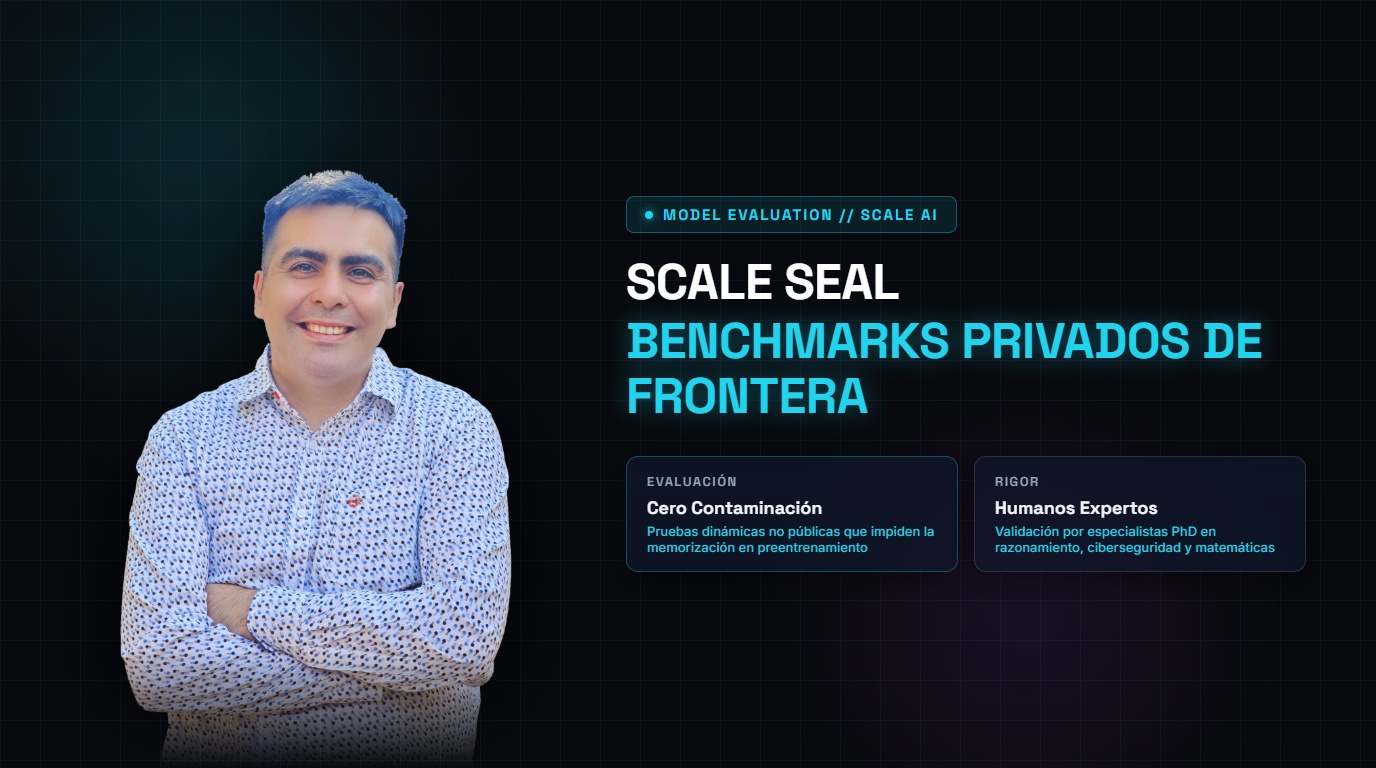
Scale AI anunció el lanzamiento de SEAL (Safety, Evaluations, and Alignment Lab), una iniciativa de vanguardia dedicada a establecer tablas de clasificación independientes, confiables y a prueba de contaminación para evaluar modelos de lenguaje de frontera. Ante la creciente crisis de contaminación de datos donde los modelos memorizan los problemas de benchmarks públicos como GSM8K o MMLU durante el preentrenamiento, SEAL implementa evaluaciones dinámicas privadas generadas y verificadas continuamente por expertos humanos de nivel doctorado en matemáticas, codificación, ciberseguridad y razonamiento adversarial.
Capítulo 01
La noticia en una frase
Scale AI lanzó SEAL, marco de evaluación continua con benchmarks privados y dinámicos para modelos de frontera.
En los primeros resultados públicos de SEAL Leaderboards, varios modelos líderes que presumían de puntuaciones superiores al 90% en benchmarks públicos convencionales sufrieron caídas de rendimiento de entre 15 y 28 puntos porcentuales al enfrentarse a los conjuntos de datos dinámicos y no contaminados de SEAL, revelando una alta dependencia de la memorización sobre el razonamiento genuino.
Capítulo 02
El alcance que cambia la lectura
Para los líderes tecnológicos y directores de IT que deben elegir entre modelos como GPT-4o, Claude 3.5 Sonnet, Gemini 1.5 Pro o pesos abiertos como Llama 3.3, las métricas comerciales tradicionales se han vuelto engañosas. SEAL restaura la claridad empírica proporcionando una medición objetiva del verdadero estado del arte.
Capítulo 03
El mecanismo documentado
La metodología de SEAL se sustenta en tres pilares: evaluación a ciegas (blind testing), rotación periódica de preguntas inéditas y calibración mediante evaluadores de grado de maestría o doctorado que auditan cada respuesta. Además, utiliza técnicas de 'red teaming' automatizado para detectar vulnerabilidades en el alineamiento ético y de seguridad.
Capítulo 04
La relación entre las piezas
Scale AI publica tablas de clasificación abiertas con análisis pormenorizados de cada categoría técnica, ofreciendo a desarrolladores y laboratorios de investigación un panel de referencia para medir sus avances sin sesgos publicitarios.
Capítulo 05
Qué capacidad se puede atribuir
Se constata una gran eficacia para diagnosticar fallos sutiles en lógica formal, deducción matemática rigurosa y generación de exploits en entornos controlados de ciberseguridad. Sin embargo, no se debe asumir que un solo ranking capture la idoneidad de un modelo para casos de negocio altamente especializados con terminología propietaria.
Capítulo 06
La puerta de control
Los laboratorios de IA pueden someter sus modelos a evaluaciones privadas de SEAL antes del lanzamiento oficial para recibir reportes de vulnerabilidades y áreas de mejora sin divulgación prematura.
Capítulo 07
Lo que la fuente no demuestra
Scale AI advierte que SEAL no mide la eficiencia de inferencia, la latencia por token o los costes operativos de despliegue en hardware local, métricas que las organizaciones deben evaluar de forma independiente según sus restricciones presupuestarias.
Capítulo 08
Cómo probarlo sin prometer de más
Las tablas de clasificación actualizadas, metodologías de prueba y directrices de evaluación pueden consultarse en el portal público de Scale AI SEAL (`scale.com/leaderboard`).
Capítulo 09
Veredicto editorial
SEAL de Scale AI marca un punto de inflexión indispensable para la industria: cuando la inteligencia artificial avanza a velocidad vertiginosa, el rigor en la medición y la honestidad empírica son la única brújula para no confundir la memorización con la inteligencia.
Fuente oficial y reporte: Scale AI Safety, Evaluations and Alignment Lab (SEAL)