Claude Sonnet 5.5: balance entre trabajo complejo y tareas de volumen con Prompt Caching
Anthropic presentó Claude Sonnet 5.5, su modelo intermedio optimizado para tareas complejas de ingeniería de software, análisis documental y razonamiento de múltiples pasos, estableciendo una frontera económica clara entre flujos de alta exigencia cognitiva y tareas de procesamiento masivo de volumen.
Actualización económica de caché: Tras el anuncio inicial, Anthropic redujo el 7 de octubre de 2026 las tarifas de lectura de Prompt Caching a una décima parte del costo base de entrada. Esta rebaja altera significativamente el cálculo de costo por tarea cuando se reutilizan bases de código o manuales operativos extensos.
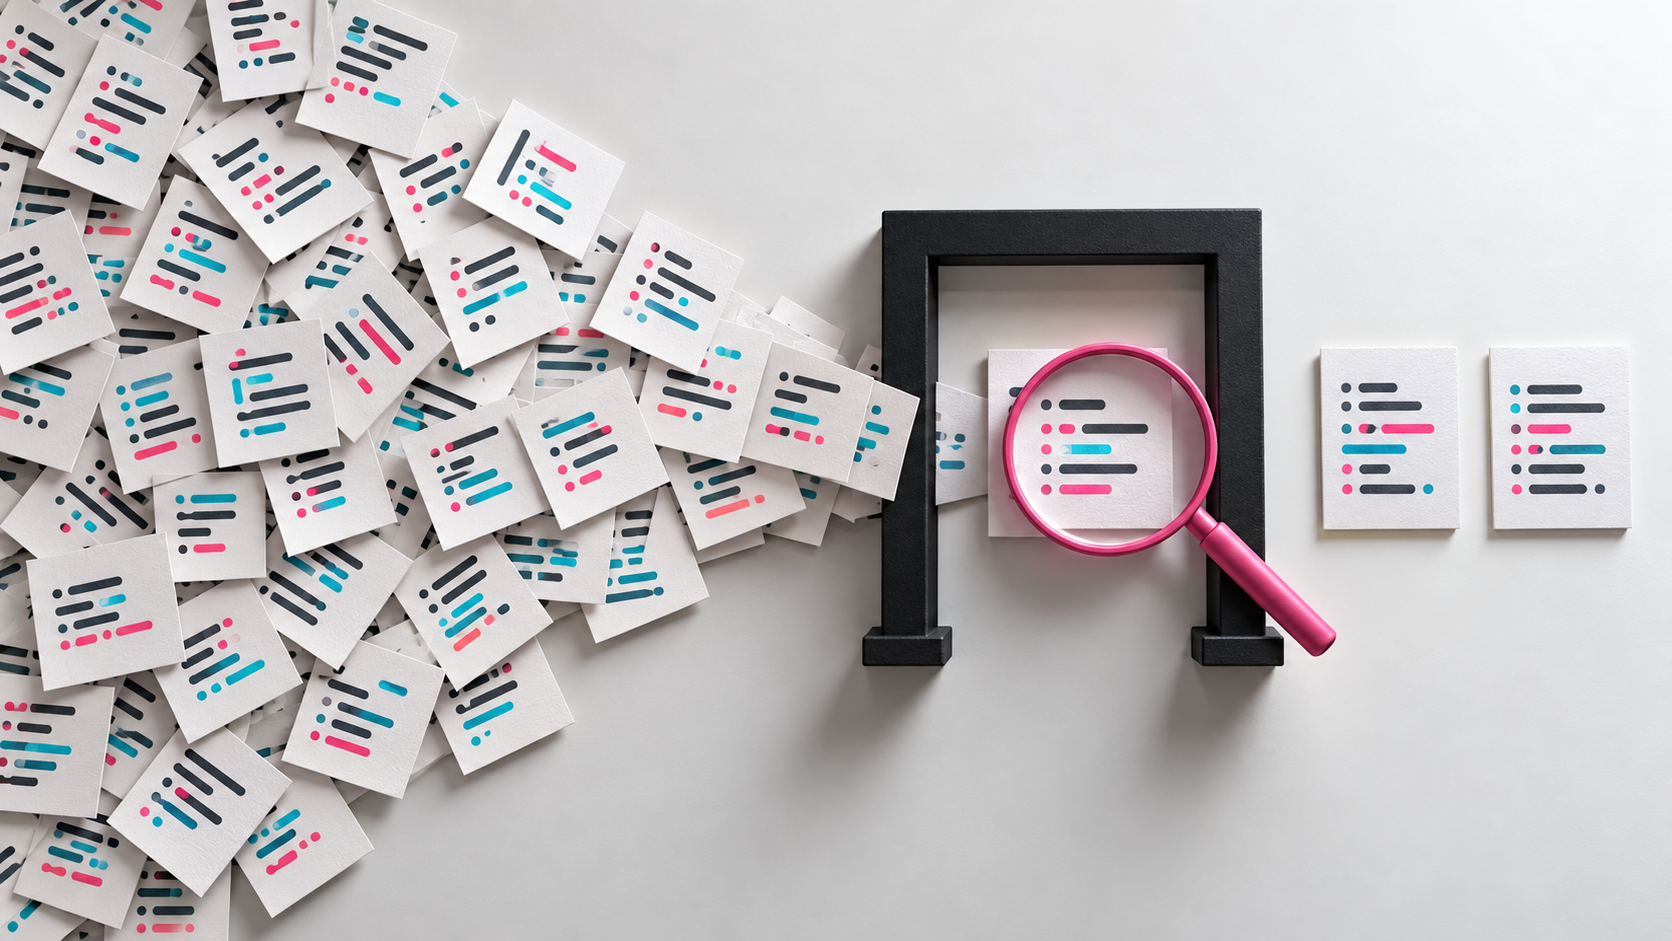
La adopción corporativa exige evitar el error de elegir un modelo único para toda la arquitectura: desplegar Sonnet 5.5 en tareas mecánicas encarece la infraestructura innecesariamente, mientras que forzar modelos ultrarrápidos de bajo costo como Haiku en excepciones complejas eleva el tiempo humano de corrección.
Separación de flujos: volumen repetitivo vs. juicio experto
Un equipo de ingeniería debe segmentar sus cargas de trabajo en dos categorías metodológicas mutuamente excluyentes antes de seleccionar el modelo de inferencia:
| Criterio de Evaluación | Tareas de Volumen (Haiku 5.5) | Tareas de Juicio y Excepción (Sonnet 5.5) |
|---|---|---|
| Naturaleza del Trabajo | Clasificación de tickets, extracción de importes, etiquetado y filtrado. | Revisión de excepciones contractuales, refactorización y auditoría de código. |
| Métrica Principal | Latencia por token y costo por millón de transacciones exitosas. | Tiempo total hasta la aceptación humana de la pieza sin retrabajo. |
| Ventaja de Prompt Caching | Ideal para inyectar esquemas JSON fijos en millones de peticiones. | Amortiza la carga de repositorios completos o normativas extensas. |
| Impacto del Fallo | Bajo; mitigable con validadores de esquema deterministas. | Crítico; un error sutil puede inducir vulnerabilidades o fallos contractuales. |
Por qué la velocidad de inferencia no garantiza productividad
Las métricas brutas de tokens por segundo divulgadas en comunicados oficiales describen el rendimiento del motor de inferencia, pero no reflejan el ciclo de vida del trabajo aceptado. Si un modelo genera una respuesta en dos segundos pero omite una cláusula obligatoria y exige diez minutos de revisión manual, la ganancia de velocidad computacional resulta nula.
Diseño de pruebas rigurosas: Una evaluación comparativa entre modelos debe congelar el conjunto de datos de entrada y las instrucciones del sistema. Modificar el prompt para beneficiar a un modelo específico desvirtúa la medición y distorsiona el costo real de mantenimiento en producción.
Pauta de aceptación por criterio independiente
Al auditar respuestas de Sonnet 5.5 sobre documentos extensos, los evaluadores deben calificar tres ejes independientes: cobertura de la pregunta, respaldo verificable mediante citas exactas y estricto apego al formato de salida. Separar estos criterios impide que una redacción elocuente disfrace información ausente o citas inventadas.
Preguntas frecuentes
¿Sonnet 5.5 reemplaza por completo la necesidad de modelos de volumen como Haiku?
No. Haiku mantiene una ventaja estructural en costos y latencia para clasificaciones rápidas y procesamiento masivo de datos estructurados.
¿Cómo influyó la reducción tarifaria de Prompt Caching del 7 de octubre?
Permitió reutilizar contextos de hasta 200.000 tokens a un costo marginal del 10% del precio de entrada normal, favoreciendo arquitecturas agénticas con memoria fija.
¿Qué significa «tiempo hasta aceptación» en la medición de LLMs?
Es el tiempo acumulado entre la solicitud inicial, la generación del modelo y las iteraciones de supervisión humana requeridas hasta que el entregable puede publicarse o desplegarse.
Fuentes: Anuncio Oficial de Claude Sonnet 5.5 (Anthropic) y Especificaciones de Claude Haiku 5.5.