Noticias IA · Visión y Lenguaje, Modelos Abiertos y Comprensión de Video Extenso
Edición: Álvaro MaureiraFecha: 2026-11-02Fuente: Alibaba Cloud & Qwen Open Source Foundation
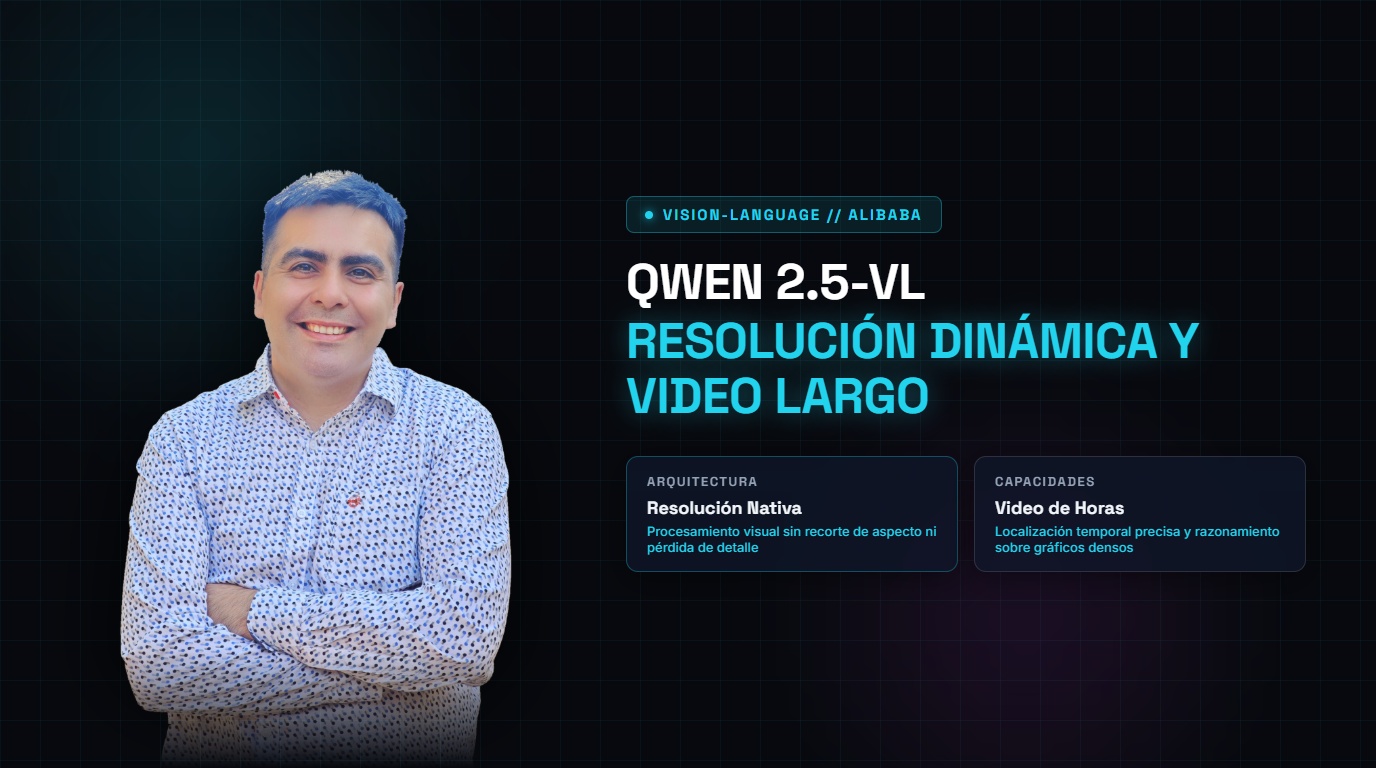
Alibaba Cloud liberó la familia Qwen 2.5-VL, sus modelos de visión y lenguaje (Vision-Language) de código abierto más avanzados hasta la fecha, disponibles en variantes de 7B y 72B parámetros. Qwen 2.5-VL introduce una arquitectura de resolución nativa dinámica capaz de procesar imágenes de cualquier relación de aspecto y resolución sin distorsión geométrica ni recortes forzados, combinada con una capacidad sin precedentes para analizar y razonar sobre videos de más de una hora de duración con localización precisa de eventos a nivel de segundo y extracción masiva de información en documentos estructurados.
Capítulo 01
La noticia en una frase
Alibaba presentó Qwen 2.5-VL, liderando comprensión visual y de video de más de una hora sin distorsión de escala.
En noviembre de 2026, Alibaba publicó los pesos de Qwen 2.5-VL en Hugging Face y ModelScope. En el benchmark estándar de visión de documentos DocVQA, Qwen 2.5-VL 72B alcanzó una precisión del 95.2%, superando a GPT-4o (92.8%) y Claude 3.5 Sonnet (93.1%), al tiempo que en Video-MME (evaluación de video de larga duración) obtuvo un 84.5%, fijando un nuevo récord mundial absoluto entre todos los modelos públicos y privados.
Capítulo 02
El alcance que cambia la lectura
La gran mayoría de modelos multimodales convierten las imágenes en cuadrículas fijas de tamaño predefinido, lo que destruye el texto fino en diagramas anchos o aplasta la tipografía en páginas verticales escaneadas. Qwen 2.5-VL supera esta limitación tratando a cada imagen como una matriz continua de parches visuales cuya resolución se adapta a la densidad informativa del contenido original.
Capítulo 03
El mecanismo documentado
La arquitectura implementa un codificador Vision Transformer (ViT) con codificación posicional rotacional 2D (RoPE 2D) y un mecanismo de atención temporal adaptativo para video. El modelo procesa hasta 1.000 cuadros de video dentro de una ventana de contexto de 128k tokens, correlacionando pistas auditivas y visuales con marcas de tiempo explícitas.
Capítulo 04
La relación entre las piezas
Qwen 2.5-VL se integra de forma directa con los principales frameworks de despliegue abierto como vLLM, Ollama y llama.cpp, facilitando a las empresas el montaje de canalizaciones locales de análisis de contratos, radiografías médicas e inventarios en video sin depender de APIs propietarias.
Capítulo 05
Qué capacidad se puede atribuir
Se comprueba una habilidad excepcional para localizar momentos específicos en grabaciones extensas (como encontrar el instante exacto en que un panel de instrumentos marca una alarma en una planta industrial). Sin embargo, no se debe asumir que el modelo pueda inferir intenciones ocultas de personas en video sin contexto conductual previo evidente.
Capítulo 06
La puerta de control
Al distribuirse bajo licencia abierta permisiva, los equipos corporativos pueden realizar ajuste fino (fine-tuning) supervisado con sus propios manuales técnicos e informes confidenciales manteniendo aislamiento estricto en servidores propios.
Capítulo 07
Lo que la fuente no demuestra
Alibaba reconoce que el procesamiento de imágenes gigantescas con resolución superior a 4K en lotes concurrentes demanda una cantidad sustancial de memoria VRAM, recomendando cuantizaciones FP8 o AWQ para entornos con hardware restringido.
Capítulo 08
Cómo probarlo sin prometer de más
Los programadores pueden evaluar el modelo en local con Ollama mediante `ollama run qwen2.5-vl:72b` o servirlo para producción en clústeres GPU mediante vLLM con soporte nativo multimodal.
Capítulo 09
Veredicto editorial
Qwen 2.5-VL consolida la hegemonía del ecosistema abierto en visión multimodal: una herramienta de escala masiva que democratiza la lectura y comprensión del mundo visual sin barreras de licenciamiento.
Fuente oficial y reporte: alvaromaureira.cl