
Hugging Face presentó Parler-TTS, una arquitectura fundacional abierta de texto a voz (TTS) entrenada sobre decenas de miles de horas de audio público que permite generar audio de alta fidelidad guiado íntegramente por descripciones en lenguaje natural, controlando el tono, género, ritmo, emoc
Sigue leyendo las noticias clave de IA
Filtrar y personalizar
 Alibaba FunAudioLLM Presenta CosyVoice: Síntesis de Voz Multilingüe y Clonación Cero-Disparo con Control EmocionalAlibaba FunAudioLLM libera CosyVoice, modelo fundacional abierto de síntesis y clonación de voz multilingüe con control fino de emociones y prosodia.Leer análisis completo
 ByteDance Presenta Seed-TTS: Familia de Modelos de Síntesis de Voz con Clonación Cero Muestras y Expresividad HumanaByteDance introduce Seed-TTS, modelo de síntesis de voz con clonación cero muestras en 3 segundos y expresividad emocional humana fotorrealista.Leer análisis completo
 Fish Audio Presenta Fish-Speech 1.5: Síntesis de Voz Autorregresiva Abierta con Clonación Cero Muestras y Compresión Dual-ARFish Audio lanza Fish-Speech 1.5, modelo abierto de TTS autorregresivo con clonación de voz en segundos, alta fidelidad acústica y soporte multilingüe.Leer análisis completo
 Hugging Face Presenta Distil-Whisper: Destilación de Modelos de Voz con 6x Mayor Velocidad y Paridad de PrecisiónHugging Face presenta Distil-Whisper, reduciendo la latencia de Whisper en 6 veces y el tamaño en un 49% con paridad de precisión en transcripción de voz.Leer análisis completo
 Meta FAIR Presenta SeamlessM4T v2: Modelo Fundacional Abierto de Traducción Multimodal de Voz y TextoMeta FAIR lanza SeamlessM4T v2, modelo fundacional abierto que unifica traducción multilingüe de voz a voz, voz a texto y texto a voz en casi 100 idiomas.Leer análisis completo
 Suno Presenta v4: Modelo Generativo de Audio y Música en 48 kHz con Alta Fidelidad Sonora y Estructura Musical ComplejaSuno presenta v4, modelo de generación musical en 48 kHz con fidelidad de estudio, alineación lírica precisa y estructura armónica sin artefactos metálicos.Leer análisis completo
 Kyutai Presenta Mimi: Codec de Audio Neuronal Abierto de Ultra Baja Latencia para Modelos de VozKyutai libera Mimi, codec de audio neuronal abierto que combina tokens acústicos y semánticos a 12,5 Hz para síntesis de voz interactiva a baja latencia.Leer análisis completo
 Mistral presenta Voxtral 3: transcripción, síntesis y agentes de vozUna guía para entender audio, turnos y acciones en agentes de voz, con un ensayo hipotético y una pauta de evaluación antes de conectar sistemas reales.Leer análisis completo
 Hugging Face Presenta LeRobot: Plataforma Abierta para Democratizar la Robótica con Aprendizaje por ImitaciónHugging Face lanza LeRobot, un marco abierto que proporciona modelos preentrenados, datasets y simulaciones para manipular robots físicos de bajo coste.Leer análisis completo
 Hugging Face lanza Smolagents: arquitectura agéntica de primer orden basada en código Python ejecutableHugging Face lanzó Smolagents, un marco ligero donde agentes de IA ejecutan código Python nativo en lugar de llamadas JSON-RPC rígidas.Leer análisis completo
 Hugging Face Presenta SmolVLM: Modelo Multimodal Abierto de 2B para Video y Visión en Hardware LocalHugging Face lanza SmolVLM, modelo multimodal compacto de 2B parámetros optimizado para análisis de video, múltiples imágenes e inferencia visual on-device.Leer análisis completo
 Hugging Face permite comprobar modelos en TrainiumCómo interpretar las pruebas de modelos para AWS Trainium.Leer análisis completo
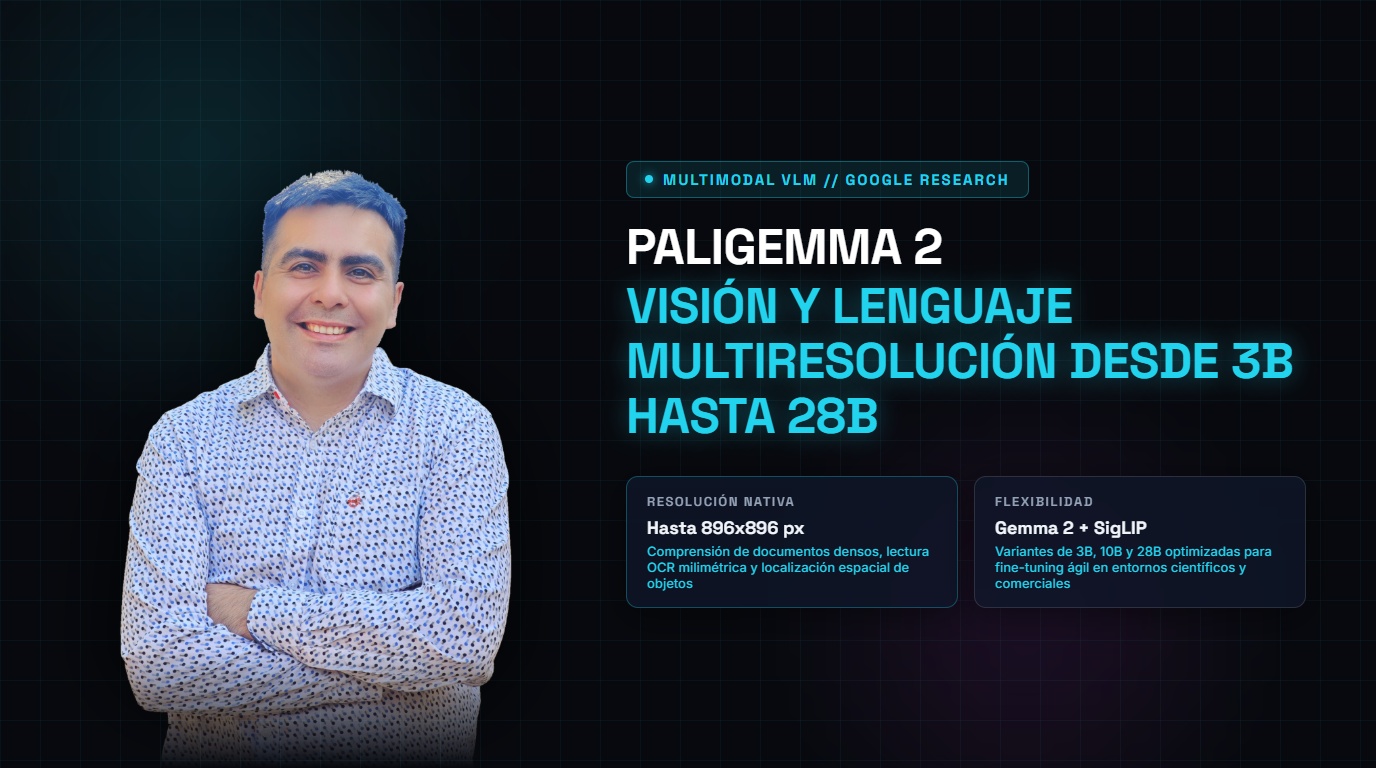 Google Lanza PaliGemma 2: Familia Abierta de Modelos de Visión y Lenguaje con Tamaños de 3B a 28B y Alta ResoluciónGoogle libera PaliGemma 2, modelos VLM basados en Gemma 2 y SigLIP entrenados con resoluciones de hasta 896px para OCR, grounding y tareas espaciales.Leer análisis completo
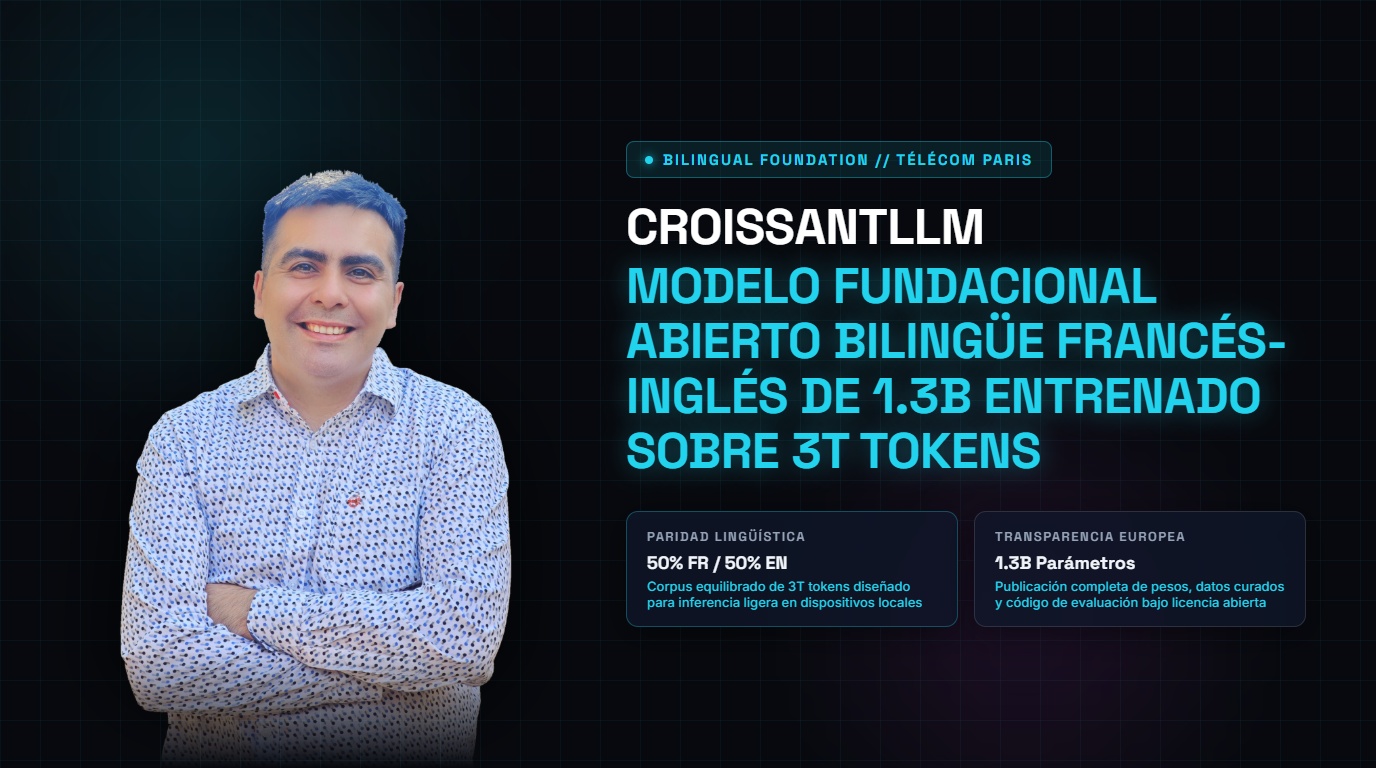 CroissantLLM: Télécom Paris y Hugging Face Presentan Modelo Abierto de 1.3B con Paridad Bilingüe Francés-InglésTélécom Paris y Hugging Face liberan CroissantLLM, modelo abierto de 1.3B entrenado sobre 3T de tokens con paridad bilingüe estricta entre francés e inglés.Leer análisis completo
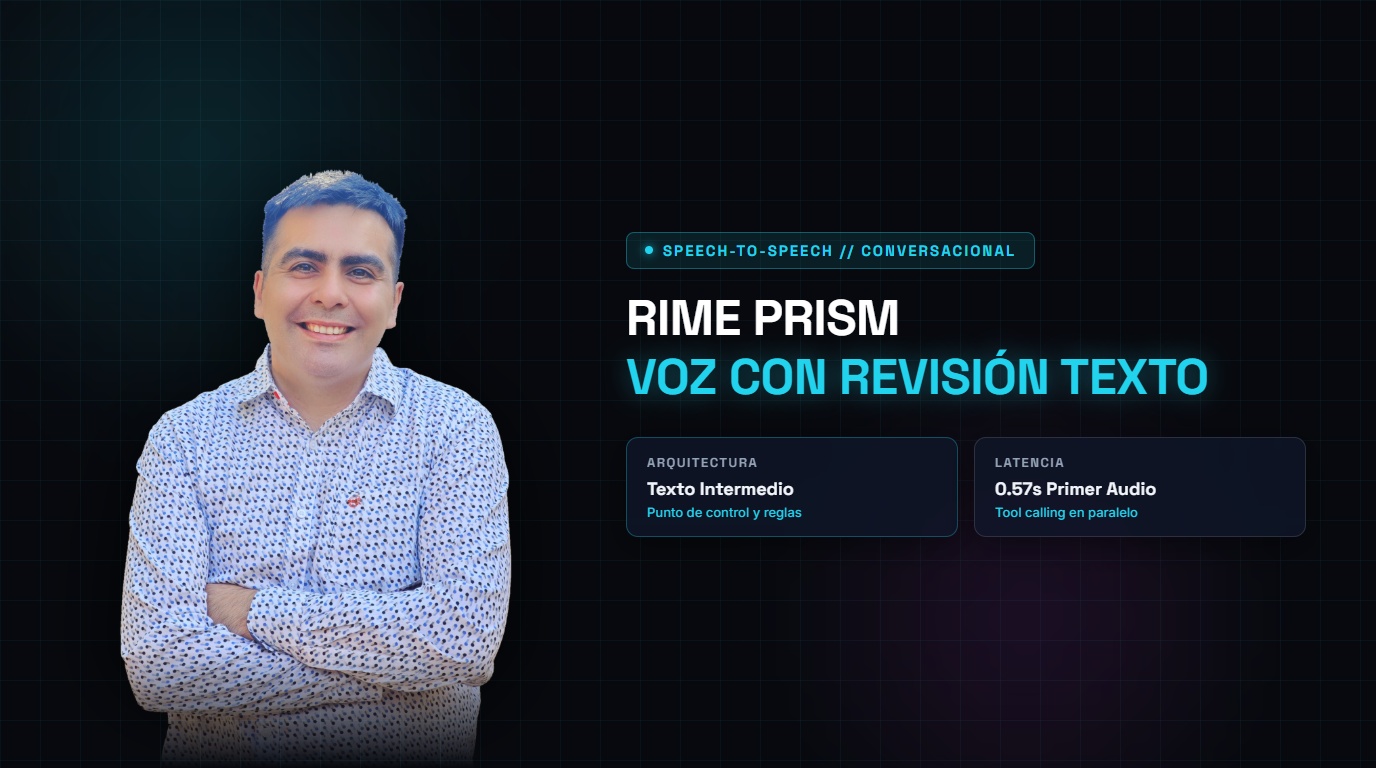 Rime presenta Prism, un modelo de voz a voz con revisión de textoRime anuncia Prism: modelo de voz a voz con capa de texto intermedia para aplicar reglas, gestionar llamadas a herramientas y auditar conversaciones.Leer análisis completo
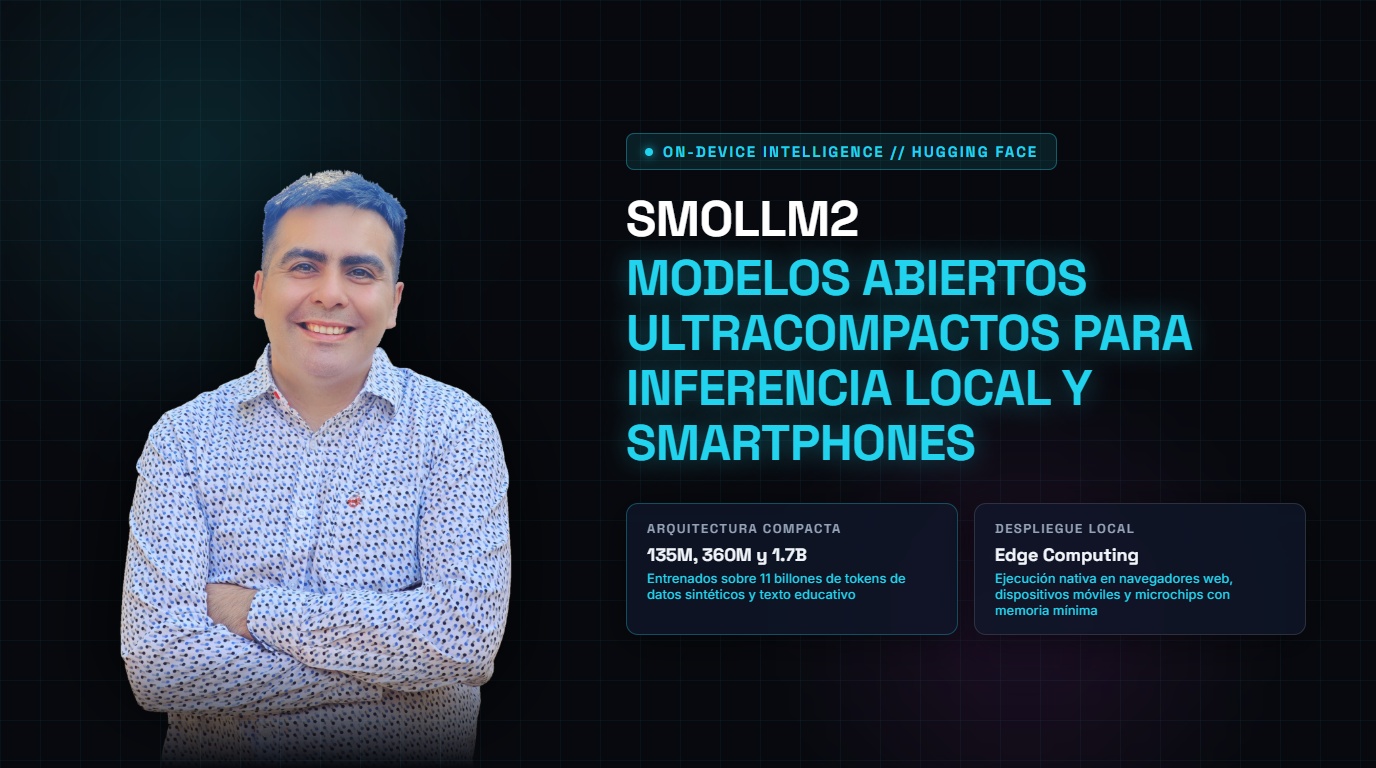 Hugging Face Presenta SmolLM2: Familia de Modelos Abiertos de 135M a 1.7B para Inferencia On-Device y Agentes LocalesHugging Face publica SmolLM2 en tamaños de 135M, 360M y 1.7B parámetros, optimizados para razonamiento local, llamadas a herramientas y despliegue on-device.Leer análisis completo