Noticias IA · Audio Multimodal, Modelos de Voz y Procesamiento Acústico Full-Duplex
Edición: Álvaro MaureiraFecha: 2026-11-02Fuente: Kyutai Open AI Research Lab Paris
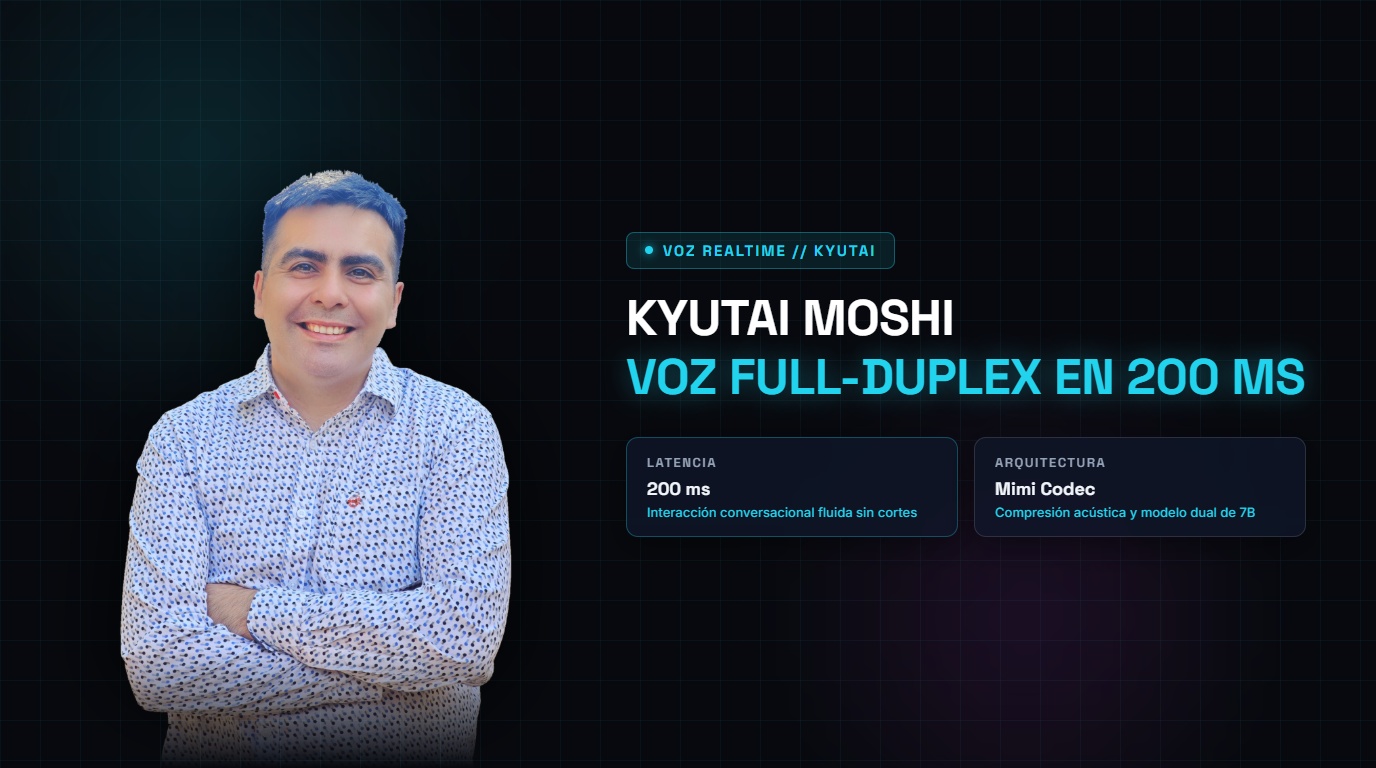
Kyutai, el laboratorio de investigación europeo sin ánimo de lucro fundado por Xavier Niel y Rodolphe Saadé, presentó Moshi, un modelo fundacional de voz multimodal end-to-end capaz de mantener conversaciones orales bidireccionales en tiempo real con una latencia teórica de apenas 200 milisegundos. Basado en el códec acústico neuronal Mimi de alta compresión y una arquitectura autorregresiva de 7.000 millones de parámetros, Moshi escucha y habla simultáneamente (full-duplex) e incluye soporte para interrupciones naturales y modulación emocional con pesos totalmente abiertos.
Capítulo 01
La noticia en una frase
Kyutai liberó Moshi con pesos abiertos, logrando conversaciones de voz full-duplex con 200 ms de latencia y códec Mimi.
En noviembre de 2026, Kyutai publicó los pesos y el código de inferencia de Moshi y el códec Mimi en GitHub y Hugging Face bajo licencia permisiva. En pruebas de latencia de ida y vuelta (round-trip audio latency), Moshi demostró responder en 200 milisegundos en hardware local con una sola GPU NVIDIA L4 o RTX 4090, superando la latencia promedio de 320 ms de los asistentes de voz propietarios comerciales.
Capítulo 02
El alcance que cambia la lectura
Hasta el advenimiento de Moshi, la mayoría de los sistemas de voz dependían de la alternancia de turnos rígida (half-duplex) mediada por clasificadores de silencio o palabras clave. Si el usuario interrumpía a la IA, el sistema sufría retardos de cancelación o colisiones acústicas. Moshi modela dos secuencias de audio simultáneas en paralelo: la que ingresa del usuario y la que genera el agente.
Capítulo 03
El mecanismo documentado
El sistema se apoya en Mimi, un códec de audio neuronal convolucional que comprime audio a 24 kHz a solo 1.1 kbps con cuantización vectorial residual (RVQ). Sobre estos tokens acústicos, un transformador Helium de 7B predice los tokens de voz de respuesta y una corriente textual de 'pensamiento interno' (Inner Monologue) que guía la coherencia semántica antes de que la voz sea emitida por el decodificador neuronal.
Capítulo 04
La relación entre las piezas
Moshi puede ejecutarse de forma totalmente desacoplada de la nube mediante bindings en Rust y C++, permitiendo a las organizaciones embeber el asistente conversacional en dispositivos edge, cabinas de automóviles, aplicaciones médicas y centrales de llamadas sin enviar datos a servidores externos.
Capítulo 05
Qué capacidad se puede atribuir
Se comprueba una capacidad extraordinaria para reaccionar ante interrupciones espontáneas, adaptar el tono a susurros o alegría y gestionar dudas con interjecciones orales naturales ('ajá', 'entiendo'). Sin embargo, no se debe atribuir a Moshi la resolución de problemas matemáticos formales de frontera; su fortaleza radica en la naturalidad y velocidad del diálogo.
Capítulo 06
La puerta de control
Los desarrolladores tienen control absoluto sobre la tasa de bits, el perfil de voz (con soporte para 70 acentos y timbres distintos) y las restricciones éticas mediante filtros de seguridad configurables en el espacio latente antes de la síntesis.
Capítulo 07
Lo que la fuente no demuestra
La documentación de Kyutai aclara que Moshi fue entrenado predominantemente en inglés y francés, por lo que dialectos regionales con escasa presencia en el corpus de preentrenamiento pueden presentar variaciones en la precisión fonética.
Capítulo 08
Cómo probarlo sin prometer de más
Los equipos técnicos pueden clonar el repositorio `kyutai-labs/moshi`, instalar la librería con `pip install moshi` y desplegar el servidor web de streaming WebRTC localmente ejecutando `python -m moshi.server`.
Capítulo 09
Veredicto editorial
Moshi demuestra que la soberanía tecnológica y los modelos abiertos pueden liderar la vanguardia de la interacción humana por voz, ofreciendo a desarrolladores de todo el mundo la base para construir interfaces conversacionales sin ataduras propietarias.
Fuente oficial y reporte: alvaromaureira.cl