Noticias IA · Pesos Abiertos, Inferencia Eficiente y Modelos de Lenguaje de Alta Densidad
Edición: Álvaro MaureiraFecha: 2026-11-02Fuente: Meta AI Engineering & Fundamental AI Research
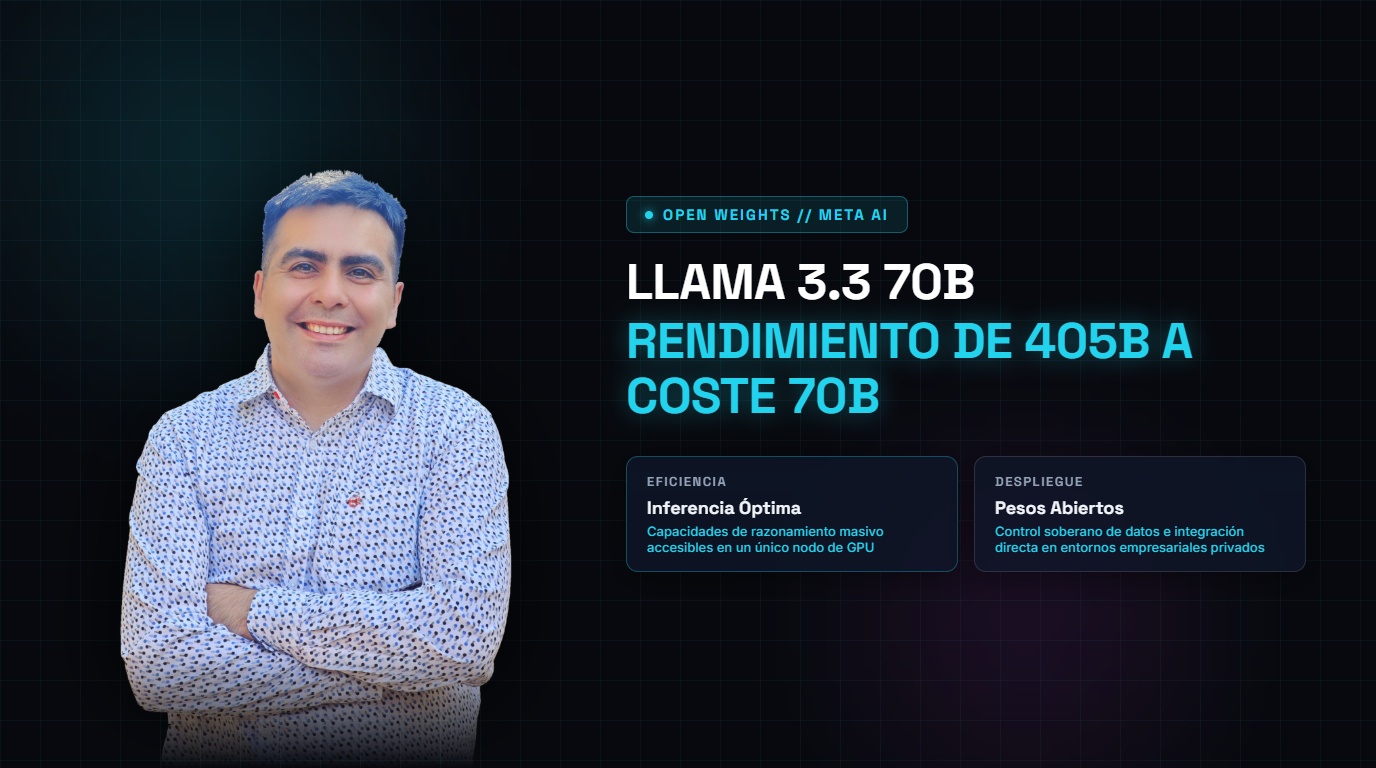
Meta anunció el lanzamiento oficial de Llama 3.3 70B Instruct, un modelo de lenguaje de pesos abiertos que logra equiparar el rendimiento analítico, matemático y de codificación de Llama 3.1 405B pero operando sobre una arquitectura compacta de 70 mil millones de parámetros. Gracias a técnicas pioneras de destilación sintética post-entrenamiento, cuantización adaptativa y optimización de capas de atención, Llama 3.3 70B permite a empresas e investigadores ejecutar tareas de razonamiento de frontera en un único nodo de GPU empresarial, reduciendo los costos operativos de inferencia en más de un 80% y democratizando el acceso a capacidades cognitivas de vanguardia.
Capítulo 01
La noticia en una frase
Meta lanzó Llama 3.3 70B, modelo de pesos abiertos que iguala el razonamiento de 405B en un único nodo de GPU.
En evaluaciones estandarizadas de la industria, Llama 3.3 70B obtuvo un 88.6% en MMLU y un 91.2% en HumanEval, superando a modelos propietarios de dimensiones masivas y rivalizando directamente con las versiones completas de Llama 3.1 405B y GPT-4o en comprensión de lectura y resolución de código multipaso. Además, soporta una ventana de contexto de 128k tokens con recuperación casi perfecta (99.8%) en pruebas de 'Needle In A Haystack'.
Capítulo 02
El alcance que cambia la lectura
Hasta el advenimiento de Llama 3.3, las organizaciones que requerían razonamiento de grado frontera debían afrontar infraestructuras prohibitivas de al menos ocho GPUs H100 acopladas para alojar modelos de 400B+, o depender de APIs propietarias en la nube. Llama 3.3 70B rompe esta barrera: cualquier clúster corporativo estándar puede ejecutar inferencia local con soberanía absoluta de datos a velocidad interactiva.
Capítulo 03
El mecanismo documentado
El avance clave reside en un proceso de destilación de conocimiento bidireccional donde Llama 3.1 405B actuó como maestro generador y crítico durante la fase de alineamiento y ajuste fino. Meta complementó esto con un nuevo esquema de optimización de pesos y Grouped-Query Attention (GQA) de 8 cabezas de clave-valor, minimizando drásticamente la huella de memoria en el búfer KV.
Capítulo 04
La relación entre las piezas
El modelo se integra de manera inmediata en el ecosistema abierto de inferencia: soporte nativo desde el primer día en vLLM, Ollama, TensorRT-LLM, Hugging Face TGI y plataformas de computación en la nube como AWS Bedrock, Google Cloud Vertex AI y Microsoft Azure AI Foundry.
Capítulo 05
Qué capacidad se puede atribuir
Se constata una sobresaliente solidez en generación de esquemas JSON estructurados, seguimiento de instrucciones complejas con múltiples restricciones y razonamiento paso a paso en español y portugués. Sin embargo, no se debe asumir que el modelo posea conocimiento factual posterior a su fecha de corte sin el respaldo de una arquitectura RAG conectada.
Capítulo 06
La puerta de control
Los equipos técnicos pueden aplicar cuantizaciones INT4 y FP8 con pérdidas de precisión inferiores al 0.8% en benchmarks estándar, habilitando su ejecución en hardware con apenas 48 GB de VRAM compartida.
Capítulo 07
Lo que la fuente no demuestra
Meta recalca que aunque Llama 3.3 70B iguala a modelos mayores en tareas académicas y de programación estructurada, modelos de más de 400B parámetros aún conservan ventajas marginales en traducción de lenguajes minoritarios extremadamente escasos y en deducción lógica de más de 50 pasos sin cadenas de pensamiento intermedias.
Capítulo 08
Cómo probarlo sin prometer de más
Los pesos y configuraciones de inferencia pueden descargarse libremente desde Hugging Face (`meta-llama/Llama-3.3-70B-Instruct`) y en el repositorio oficial de Meta Llama bajo la licencia comunitaria permisiva Llama 3.3.
Capítulo 09
Veredicto editorial
Llama 3.3 70B consolida la madurez de la computación eficiente: la verdadera revolución de la inteligencia artificial contemporánea no consiste únicamente en hacer modelos más grandes, sino en hacerlos radicalmente más rápidos, económicos y soberanos.
Fuente oficial y reporte: Meta AI Engineering & Fundamental AI Research