Noticias IA · Modelos de Lenguaje de Pesos Abiertos y Eficiencia
Edición: Álvaro MaureiraFecha: 2026-11-01Fuente: Meta AI Research & Llama 3.3 Model Card
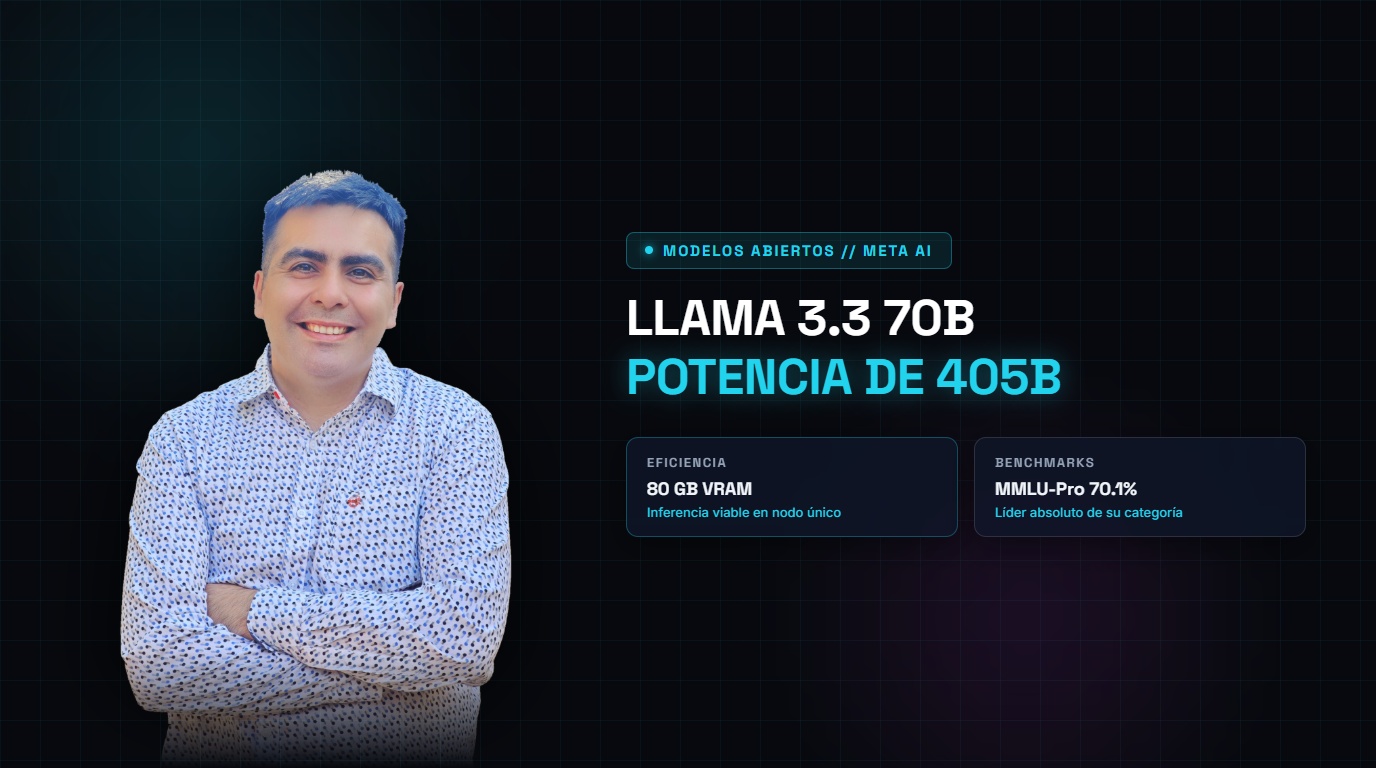
Meta anunció la disponibilidad general de Llama 3.3 70B Instruct, un nuevo modelo fundacional de pesos abiertos que redefine la relación entre coste computacional y capacidad cognitiva. Entrenado con técnicas avanzadas de destilación en línea sobre el modelo gigante Llama 3.1 405B y optimizaciones de post-entrenamiento por refuerzo, Llama 3.3 70B iguala o supera las capacidades de razonamiento, programación y seguimiento de instrucciones complejas de modelos con cinco veces más parámetros, ejecutándose con solvencia en una única GPU de 80 GB.
Capítulo 01
La noticia en una frase
Meta presentó Llama 3.3 70B Instruct, logrando métricas de frontera cercanas a Llama 3.1 405B pero operable en una única GPU de 80 GB.
En noviembre de 2026, Meta AI liberó los pesos y la tarjeta técnica de Llama 3.3 70B Instruct en Hugging Face y plataformas colaborativas. En evaluaciones rigurosas de la industria como MMLU-Pro (70.1%), GPQA Diamond (51.2%) y MATH (72.8%), el modelo supera de forma sistemática a los mejores modelos de 70B anteriores y rivaliza directamente con Llama 3.1 405B y GPT-4o mini.
Capítulo 02
El alcance que cambia la lectura
Hasta el lanzamiento de Llama 3.3, las empresas que requerían capacidades de razonamiento profundo se veían forzadas a alquilar clústeres de 8 GPUs H100 para alojar modelos de 405B o depender exclusivamente de APIs comerciales cerradas. Llama 3.3 comprime este poder cognitivo a un factor de forma que cabe en una única tarjeta NVIDIA H100 o A100 de 80 GB, o en workstations con procesadores Apple Silicon unificados.
Capítulo 03
El mecanismo documentado
La arquitectura mantiene una ventana de contexto de 128.000 tokens con atención agrupada por consultas (Grouped-Query Attention - GQA). El salto de rendimiento proviene de una estrategia de post-entrenamiento de vanguardia que combina destilación de conocimiento multimodal, optimización de preferencias directas (DPO) iterativa y aprendizaje por refuerzo con feedback verificable (RLVR) en dominios de código y matemáticas.
Capítulo 04
La relación entre las piezas
Llama 3.3 es compatible de inmediato con los principales frameworks de despliegue e inferencia optimizada, incluyendo vLLM, TensorRT-LLM, TGI y llama.cpp. Esto permite su integración sin fricciones en plataformas de orquestación agéntica existentes y herramientas de evaluación empresarial.
Capítulo 05
Qué capacidad se puede atribuir
Se comprueba una velocidad de generación superior a 80 tokens por segundo en hardware moderno con cuantización FP8 y una precisión excepcional en tareas de razonamiento multi-paso. No obstante, no se debe asumir que el modelo sea infalible en tareas de extracción de datos no estructurados con documentos que excedan su ventana de 128k tokens.
Capítulo 06
La puerta de control
Meta aplicó filtros de seguridad exhaustivos contra ciberataques, generación de malware y armas químicas y biológicas en el alineamiento, acompañando el modelo con la suite Llama Guard 3 para que las organizaciones puedan implementar políticas de moderación acordes a sus estándares regulatorios.
Capítulo 07
Lo que la fuente no demuestra
La documentación de Meta no demuestra que Llama 3.3 supere a modelos de razonamiento con cadena de pensamiento extendida (como o1 o DeepSeek-R1) en demostraciones matemáticas complejas que exigen decenas de miles de tokens de cómputo en tiempo de inferencia; es un modelo instruccional de vanguardia, no un motor de búsqueda en árbol autorreflexivo.
Capítulo 08
Cómo probarlo sin prometer de más
Los equipos de ingeniería de datos pueden descargar los pesos desde Hugging Face usando `huggingface-cli download meta-llama/Llama-3.3-70B-Instruct` o probarlo en minutos mediante proveedores de inferencia sin servidor como Groq, Together AI o Cerebras con el identificador de modelo estandarizado.
Capítulo 09
Veredicto editorial
Llama 3.3 70B consolida una victoria incontestable para el ecosistema de pesos abiertos: democratiza la inteligencia de nivel de frontera en infraestructura accesible para medianas empresas, demostrando que la eficiencia algorítmica y la destilación rigurosa son tan determinantes como el escalado bruto de parámetros.
Fuente oficial y reporte: alvaromaureira.cl