
Sigue leyendo las noticias clave de IA
Filtrar y personalizar
 Meta FAIR Presenta SeamlessM4T v2: Modelo Fundacional Abierto de Traducción Multimodal de Voz y TextoMeta FAIR lanza SeamlessM4T v2, modelo fundacionalLeer análisis completo
 Meta Presenta Spirit LM: Modelo Multimodal Fundacional de Voz y Texto con Emoción NativaMeta AI libera Spirit LM, modelo fundacional multiLeer análisis completo
 NVIDIA Presenta Llama-3.1-Nemotron-70B: Modelo de Recompensas de Alta Precisión para Alineamiento de LLMsNVIDIA lanza Llama-3.1-Nemotron-70B-Reward, modeloLeer análisis completo
 Meta Presenta Spirit LM: Modelo Fundacional de Código Abierto que Unifica Texto y Voz con Expresividad EmocionalMeta lanza Spirit LM, modelo fundacional de pesos.Leer análisis completo
 Baichuan Presenta Baichuan-Omni: Modelo Multimodal de Video 720p, Audio y TextoBaichuan libera Baichuan-Omni, modelo de 7B capaz.Leer análisis completo
 Rime presenta Prism, un modelo de voz a voz con revisión de textoRime anuncia Prism: modelo de voz a voz con capa dLeer análisis completo
 THUDM Presenta GLM-4-Voice: Modelo Multimodal de Voz a Voz en Tiempo Real con Comprensión Acústica DirectaZhipu AI y Tsinghua liberan GLM-4-Voice, modelo muLeer análisis completo
 Kyutai presenta Moshi: el modelo de voz multimodal en tiempo real con 200 milisegundos de latencia y pesos abiertosKyutai libera Moshi, modelo de diálogo por voz fulLeer análisis completo
 Baichuan Presenta Baichuan-Omni: Modelo Multimodal Abierto de Procesamiento de Voz, Video y Texto en Tiempo RealBaichuan presenta Baichuan-Omni, modelo de 7B paraLeer análisis completo
 Reka AI Presenta Reka Core: Modelo Multimodal Frontera Independiente con Procesamiento Nativo de Texto, Video y AudioReka AI presenta Reka Core, modelo multimodal fronLeer análisis completo
 NVIDIA Presenta Llama-3.1-Nemotron-70B-Instruct: Superando a Modelos PropietariosNVIDIA lanza Llama-3.1-Nemotron-70B-Instruct, modeLeer análisis completo
 Nexusflow Presenta Starling-LM 7B: Modelo Abierto Optimizado con RLAIF que Lidera Benchmarks ConversacionalesNexusflow y UC Berkeley liberan Starling-LM 7B, moLeer análisis completo
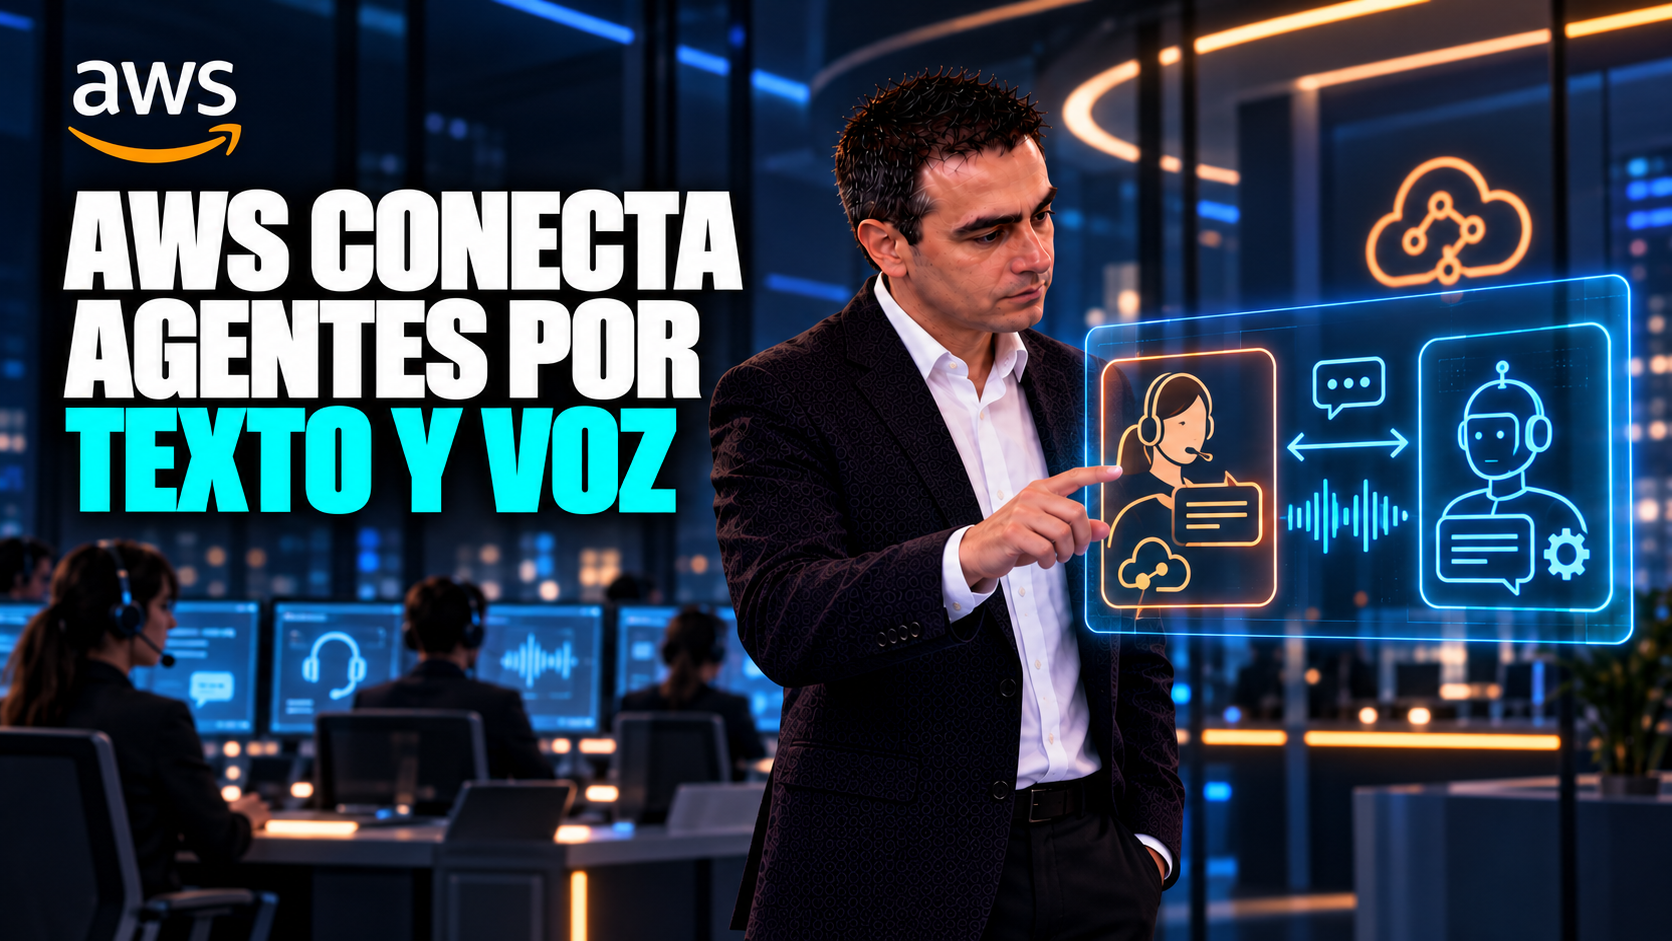 AWS anuncia colaboración A2A de texto y voz para Amazon Connect CustomerAWS anunció A2A de texto y voz en Amazon Connect CLeer análisis completo
 Hexgrad Presenta Kokoro-82M: Modelo de Síntesis de Voz de 82 Millones de Parámetros con Rendimiento Superior a Tiempo RealHexgrad libera Kokoro-82M, modelo ligero de síntesLeer análisis completo
 Apple Presenta Ferret-UI: Modelo Multimodal para Agentes de Interfaz MóvilApple publica Ferret-UI, modelo multimodal optimizLeer análisis completo
 ByteDance Presenta Seed-Music: Modelo Fundacional de Generación Musical con Control de Timbre y Edición MultimodalByteDance introduce Seed-Music, un modelo fundacioLeer análisis completo