
Microsoft Research presentó BitBLAS, una biblioteca de alto rendimiento que redefine las operaciones fundamentales de álgebra lineal básica (BLAS) para admitir de forma nativa formatos numéricos sub-byte como INT4, INT2 e INT1 (ternario y binario) directamente en GPUs modernas sin el coste
Sigue leyendo las noticias clave de IA
Filtrar y personalizar
 Microsoft Presenta DeepSpeed-FastGen: Inferencia de Alto Rendimiento con Dynamic SplitFuseMicrosoft presenta DeepSpeed-FastGen con Dynamic SplitFuse, técnica que unifica la ingestión y generación de tokens para disparar el throughput en GPUs.Leer análisis completo
 Microsoft y CENIA acuerdan apoyo en la nube e investigación para Latam GPTMicrosoft y CENIA anunciaron apoyo en infraestructura de nube e investigación para el proyecto regional Latam GPT.Leer análisis completo
 Microsoft Presenta DeepSpeed-MII: Servicio de Inferencia de Baja Latencia y Coste Mínimo para Modelos MasivosMicrosoft presenta DeepSpeed-MII, acelerando hasta 4.3x la inferencia de LLMs y reduciendo hasta 40x el coste por token mediante kernels ZeRO optimizados.Leer análisis completo
 Haiku 5.5: medir el costo de una tarea aceptadaAnálisis del costo total de Claude Haiku 5.5: impacto del nuevo tokenizador, umbrales de contexto, reglas de abstención y condiciones de créditos mensuales.Leer análisis completo
 SenseTime Libera LightLLM: Motor de Inferencia Liviano de Alto Rendimiento con Co-Diseño de Algoritmos y SistemasSenseTime presenta LightLLM, motor de inferencia liviano que maximiza la ocupación de memoria en GPUs y cuadruplica el throughput mediante gestión por token.Leer análisis completo
 Apple Libera CoreNet: Biblioteca de Código Abierto para Entrenamiento y Optimización de Modelos de IA a Gran EscalaApple presenta CoreNet, framework abierto para entrenar redes profundas y modelos multimodales a gran escala con soporte unificado para CUDA y Apple Silicon.Leer análisis completo
 Meta Libera Chameleon: Modelos Fundacionales Abiertos que Procesan y Generan Texto e Imágenes de Forma Totalmente EntrelazadaMeta libera Chameleon, modelos abiertos que fusionan texto e imagen en una secuencia única para comprender y generar ambos modos de forma entrelazada.Leer análisis completo
 University of Washington Presenta FlashInfer: Biblioteca de Kernels GPU Acelerados para Servicio Eficiente de LLMsUW y SambaNova presentan FlashInfer, suite de kernels CUDA optimizados para atención paginada y aceleración de inferencia de LLMs con cero sobrecarga.Leer análisis completo
 Microsoft presenta Phi-4: modelo compacto de 14B parámetros con razonamiento sintético de vanguardia y rendimiento matemático superiorMicrosoft anunció Phi-4, modelo de 14B entrenado con datos sintéticos curados que supera a modelos mayores en razonamiento y matemáticas.Leer análisis completo
 RWKV Foundation Presenta RWKV-v6 Finch: Arquitectura Lineal RNN con Estado Matricial para Secuencias InfinitasRWKV Foundation lanza RWKV-v6 Finch, arquitectura que combina la expresividad de los Transformers con el costo de memoria constante O(1) de redes recurrentes.Leer análisis completo
 NVIDIA Presenta TensorRT-LLM: Compilación y Aceleración de Inferencia de LLMs con FP8 en GPUs Tensor CoreNVIDIA libera TensorRT-LLM, biblioteca abierta para optimizar y compilar inferencia de LLMs con in-flight batching y cuantización FP8 en GPUs Tensor Core.Leer análisis completo
 FlashAttention-3: Stanford y Princeton Aceleran la Atención Exacta hasta 1.2 PFLOPs en GPUs Hopper con Asincronía y FP8Investigadores de Stanford y Princeton presentan FlashAttention-3, acelerando la atención exacta hasta 1,2 PFLOPs en GPUs Hopper con asincronía y FP8.Leer análisis completo
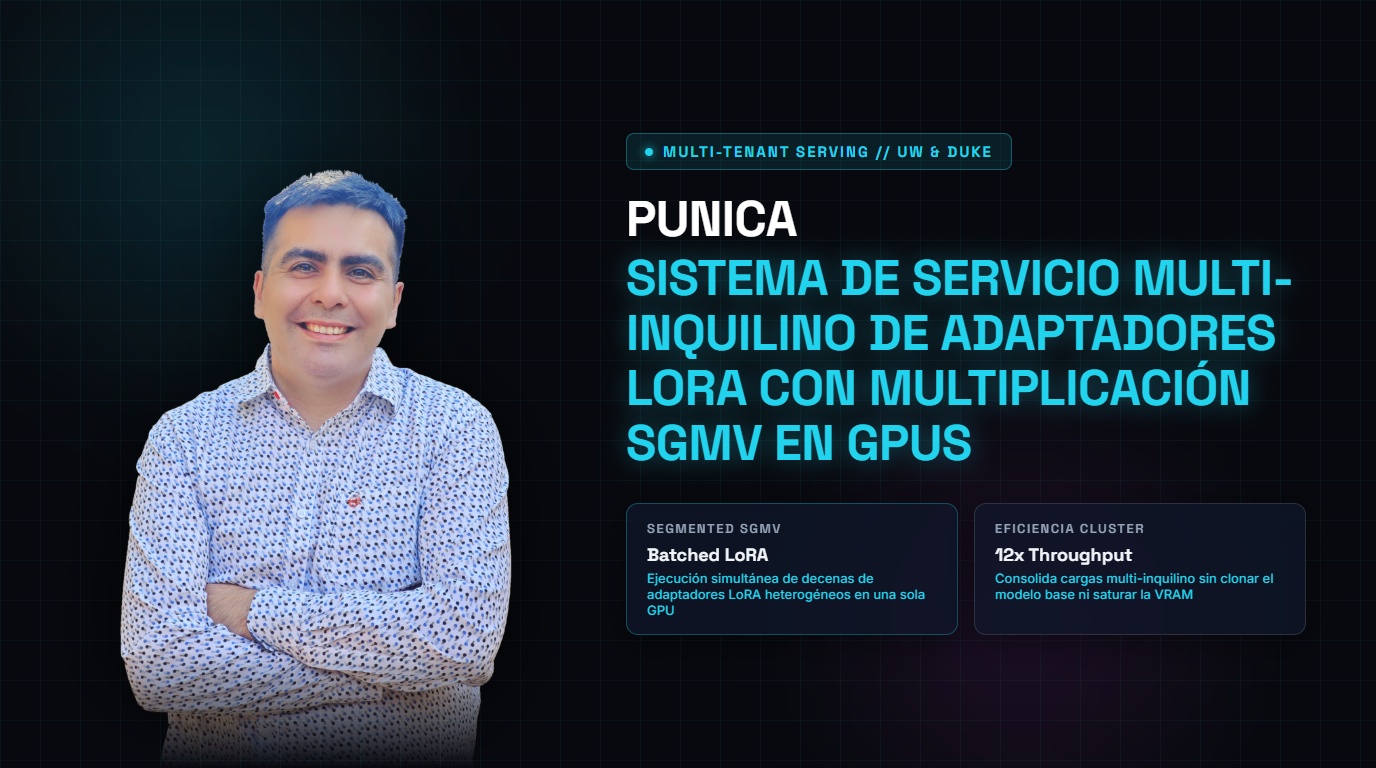 University of Washington y Duke Presentan Punica: Servicio Multi-Inquilino de LoRA con SGMV en GPUsUW y Duke presentan Punica, sistema de inferencia que permite servir decenas de modelos LoRA sobre un modelo base compartido en una sola GPU con kernels SGMV.Leer análisis completo
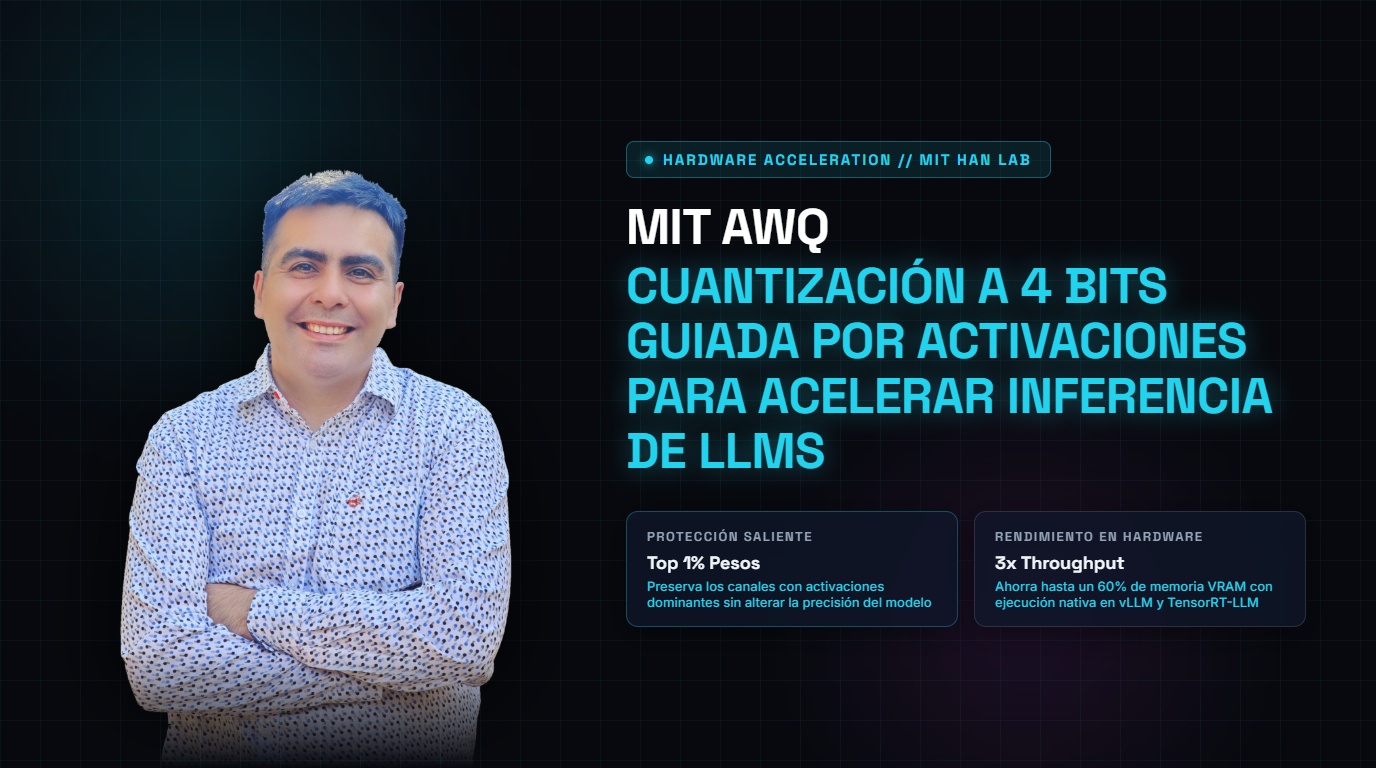 MIT HAN Lab Presenta AWQ: Cuantización a 4 Bits Guiada por Activaciones para Acelerar la Inferencia de LLMsMIT HAN Lab libera AWQ, técnica de cuantización a 4 bits guiada por activaciones que acelera la inferencia de LLMs hasta 3x sin pérdida de precisión.Leer análisis completo
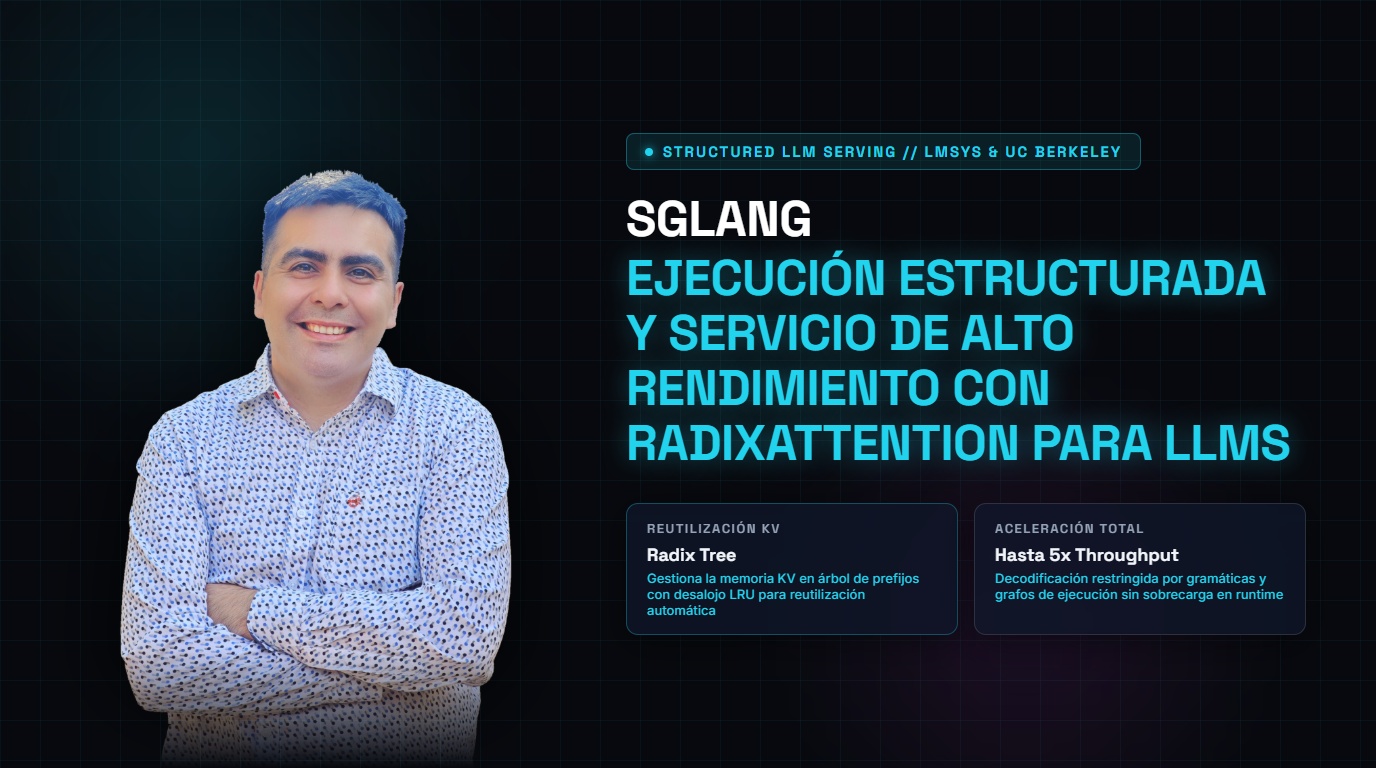 LMSYS y UC Berkeley Presentan SGLang: Servicio de LLMs con RadixAttention y Rendimiento hasta 5xLMSYS y UC Berkeley presentan SGLang, marco de ejecución estructurada y servicio de LLMs con RadixAttention que multiplica el rendimiento hasta 5x.Leer análisis completo
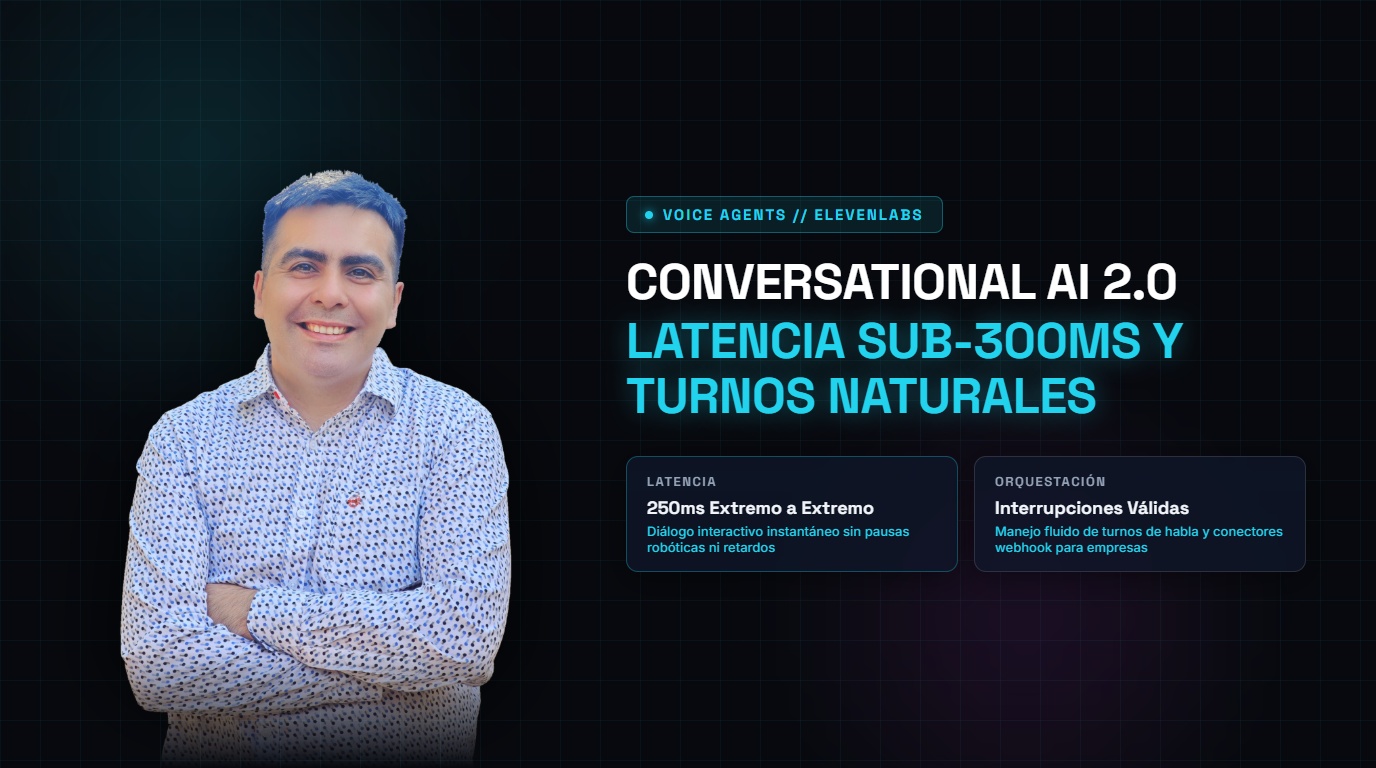 ElevenLabs Lanza Conversational AI 2.0: Agentes de Voz con Latencia Sub-300ms y Manejo Natural de TurnosElevenLabs presenta Conversational AI 2.0 para desplegar agentes de voz con latencia de 250ms, interrupciones naturales y conectores Webhook para empresas.Leer análisis completo