
Investigadores de Stanford y Princeton presentaron FlashAttention-3, una reimplementación radical del algoritmo de atención exacta que explota la asincronía de hardware, la especialización por grupos de hilos y el formato FP8 en GPUs NVIDIA Hopper para alcanzar rendimientos sin precedentes de hasta 1,2 PFLOPs.
Sigue leyendo las noticias clave de IA
Filtrar y personalizar
 Together AI y Stanford Presentan Flash-Decoding: Aceleración de Generación de LLMs hasta 8x en Contextos LargosTogether AI y Stanford presentan Flash-Decoding, técnica que paraleliza la atención en secuencias largas acelerando la generación de LLMs hasta 8x en GPUs.Leer análisis completo
 Stanford FutureData Presenta ColBERTv2: Recuperación Densa por Tokens con Compresión Residual y Huella 10x MenorStanford FutureData presenta ColBERTv2, arquitectura de interacción tardía con compresión residual que reduce el índice 10x manteniendo alta precisión en RAG.Leer análisis completo
 NVIDIA Presenta TensorRT-LLM: Compilación y Aceleración de Inferencia de LLMs con FP8 en GPUs Tensor CoreNVIDIA libera TensorRT-LLM, biblioteca abierta para optimizar y compilar inferencia de LLMs con in-flight batching y cuantización FP8 en GPUs Tensor Core.Leer análisis completo
 Together AI y Princeton Presentan Medusa: Muestreo Especulativo con Múltiples Cabezales para Acelerar LLMs hasta 3xTogether AI y Princeton presentan Medusa, marco de decodificación especulativa con múltiples cabezales que acelera la inferencia de LLMs hasta 3x sin borrador.Leer análisis completo
 University of Washington y Duke Presentan Punica: Servicio Multi-Inquilino de LoRA con SGMV en GPUsUW y Duke presentan Punica, sistema de inferencia que permite servir decenas de modelos LoRA sobre un modelo base compartido en una sola GPU con kernels SGMV.Leer análisis completo
 DeepSeek Presenta DeepSeek-V3: Arquitectura MoE de 671B con Multi-Head Latent Attention y FP8 MixtoDeepSeek lanza DeepSeek-V3, modelo MoE de 671B con 37B activos por token, Multi-Head Latent Attention y entrenamiento en FP8 con costo ultraeficiente.Leer análisis completo
 Microsoft Research Libera BitBLAS: Biblioteca de Operaciones Matriciales para Cuantización Sub-Byte en GPUsMicrosoft Research presenta BitBLAS, biblioteca BLAS de alto rendimiento para acelerar hasta 8x la inferencia de modelos cuantizados a precisión sub-byte.Leer análisis completo
 Zyphra Presenta Zamba2: Arquitectura Híbrida Mamba2-Transformer con Atención Compartida para Inferencia UltrarrápidaZyphra presenta Zamba2, modelos híbridos Mamba2-Transformer con atención compartida para inferencia ultrarrápida y mínimo consumo de memoria VRAM.Leer análisis completo
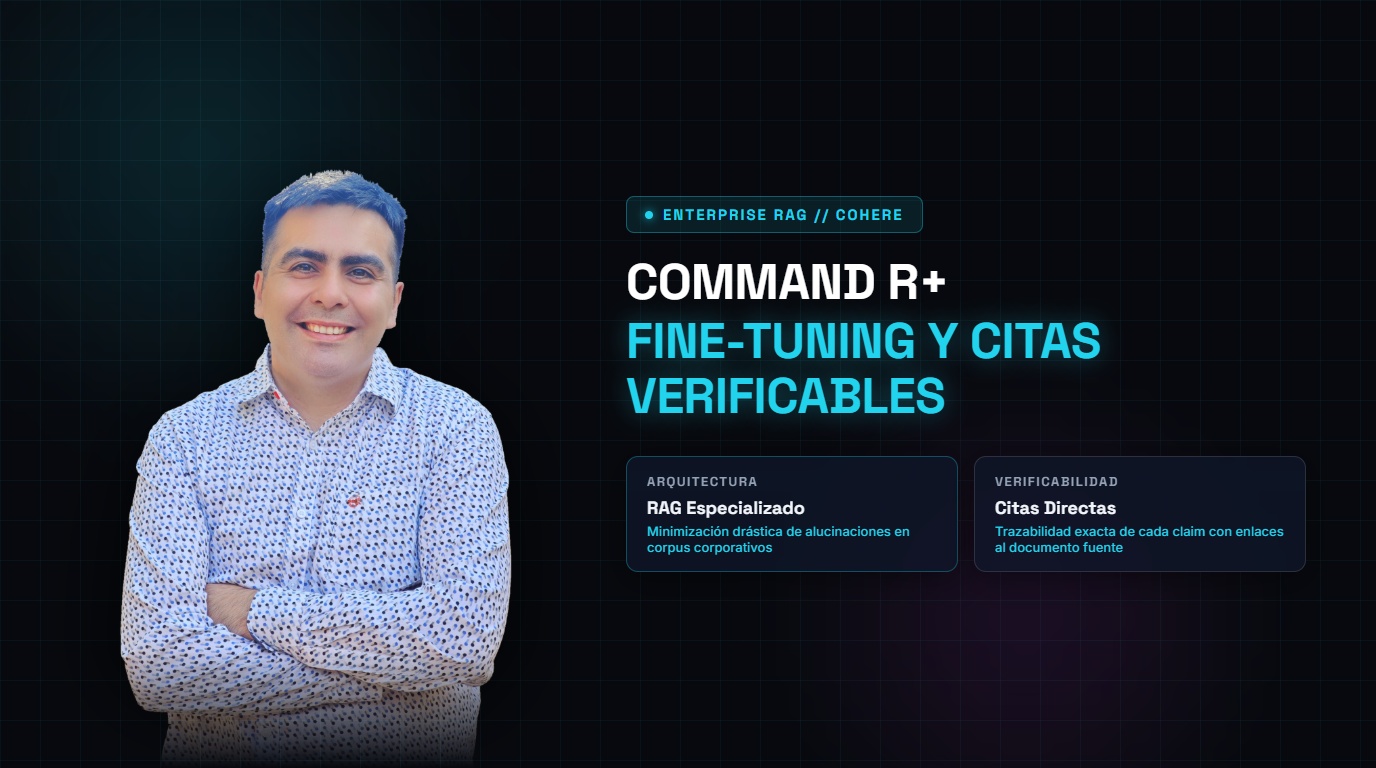 Cohere Command R+: Especialización y Fine-Tuning de RAG para Empresas con Citas VerificablesAnálisis de Cohere Command R+ con fine-tuning para RAG empresarial, reducción de alucinaciones y citas verificables en bases de conocimiento corporativas.Leer análisis completo
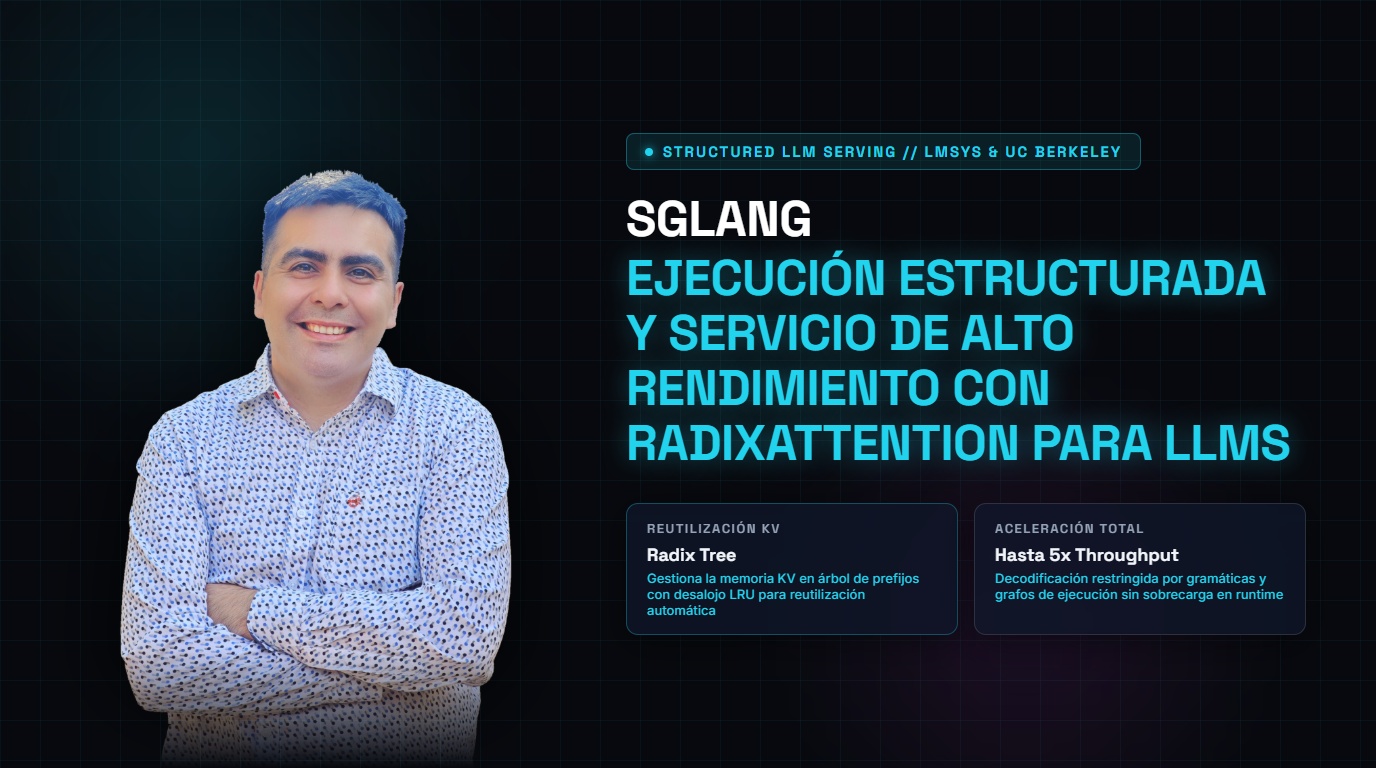 LMSYS y UC Berkeley Presentan SGLang: Servicio de LLMs con RadixAttention y Rendimiento hasta 5xLMSYS y UC Berkeley presentan SGLang, marco de ejecución estructurada y servicio de LLMs con RadixAttention que multiplica el rendimiento hasta 5x.Leer análisis completo
 Agreement Analyzer: precedentes, revisión y decisión humanaEl caso empresarial explicado mediante sus materiales, salidas y límites de evaluación.Leer análisis completo
 Stanford: aprender para adoptar IACómo introducir IA con tiempo para aprender y evaluar su valor.Leer análisis completo
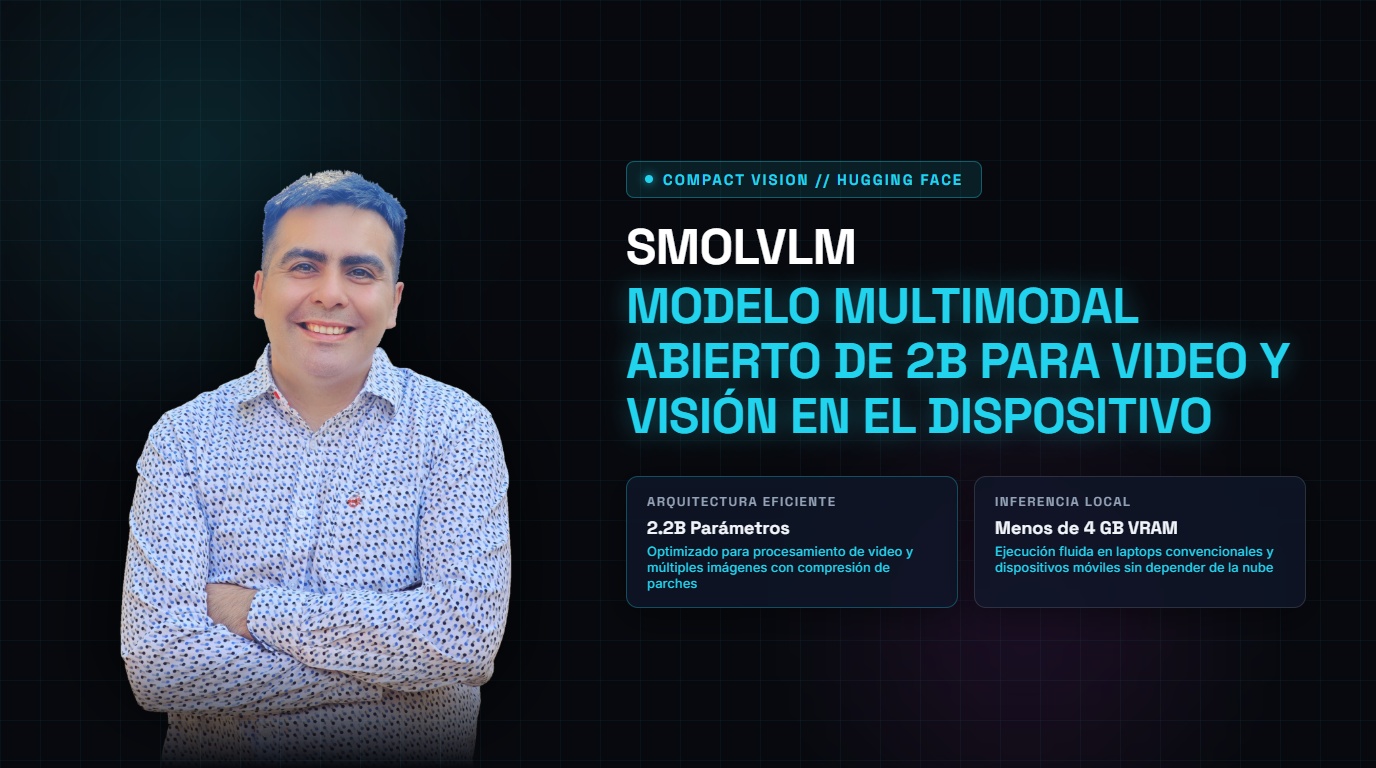 Hugging Face Presenta SmolVLM: Modelo Multimodal Abierto de 2B para Video y Visión en Hardware LocalHugging Face lanza SmolVLM, modelo multimodal compacto de 2B parámetros optimizado para análisis de video, múltiples imágenes e inferencia visual on-device.Leer análisis completo
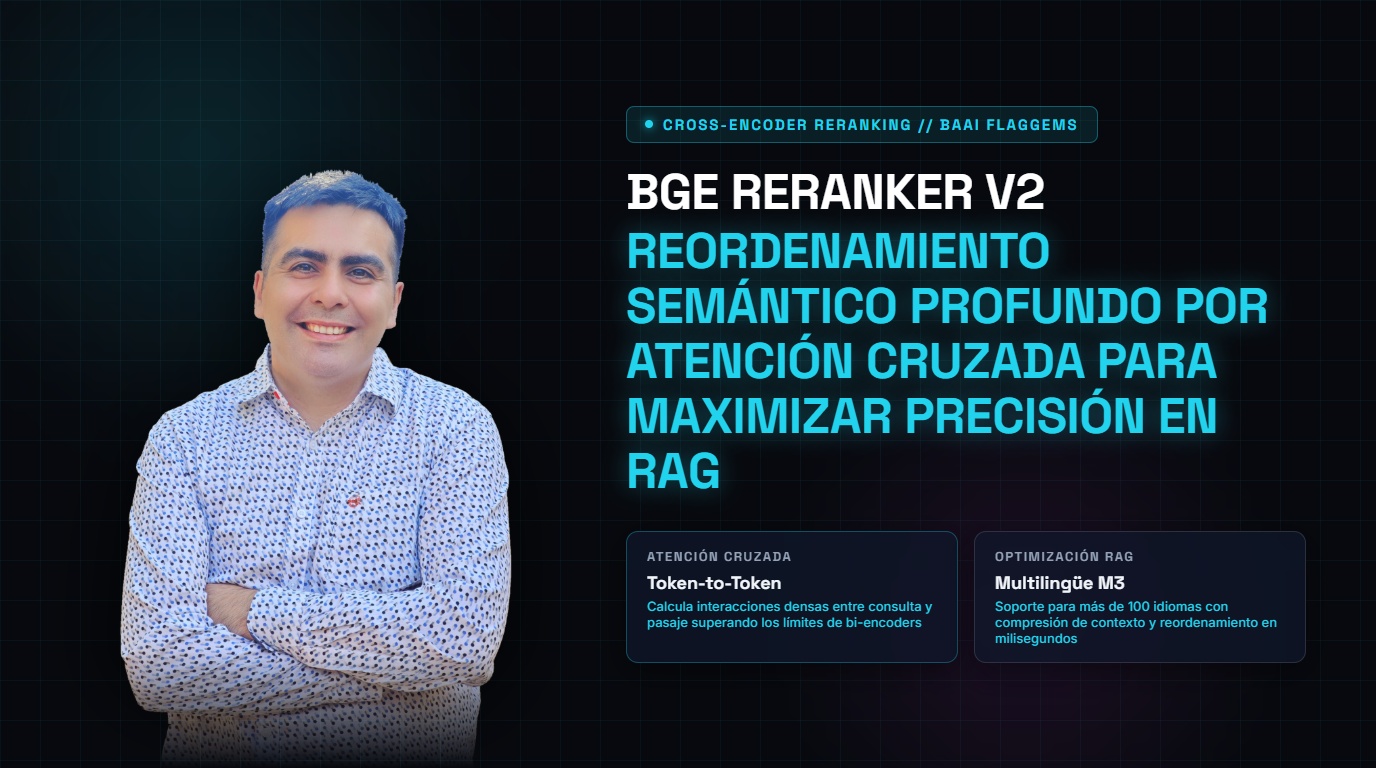 BAAI Presenta BGE Reranker v2: Reordenamiento Semántico Profundo por Atención Cruzada para RAGBAAI libera BGE Reranker v2, modelo de reordenamiento semántico basado en atención cruzada que maximiza la precisión de recuperación en sistemas RAG.Leer análisis completo
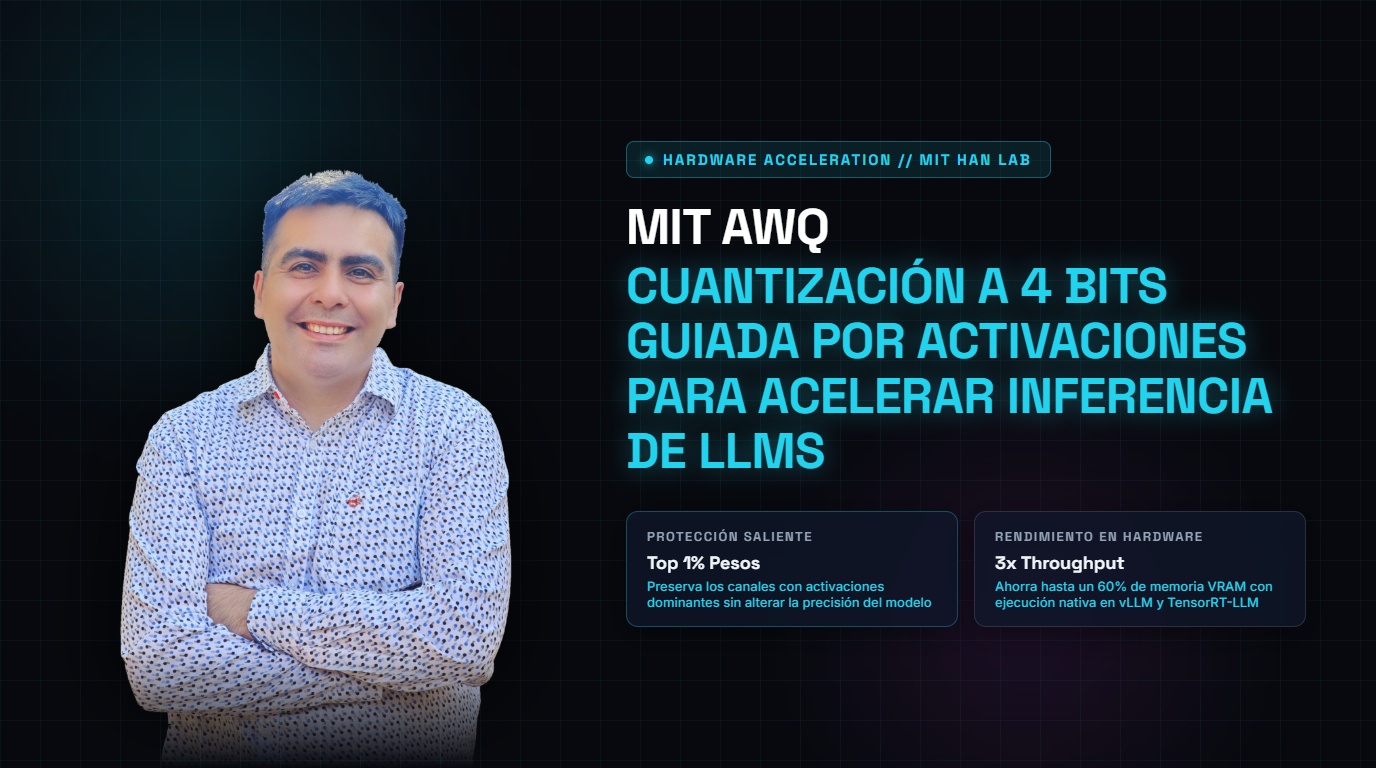 MIT HAN Lab Presenta AWQ: Cuantización a 4 Bits Guiada por Activaciones para Acelerar la Inferencia de LLMsMIT HAN Lab libera AWQ, técnica de cuantización a 4 bits guiada por activaciones que acelera la inferencia de LLMs hasta 3x sin pérdida de precisión.Leer análisis completo
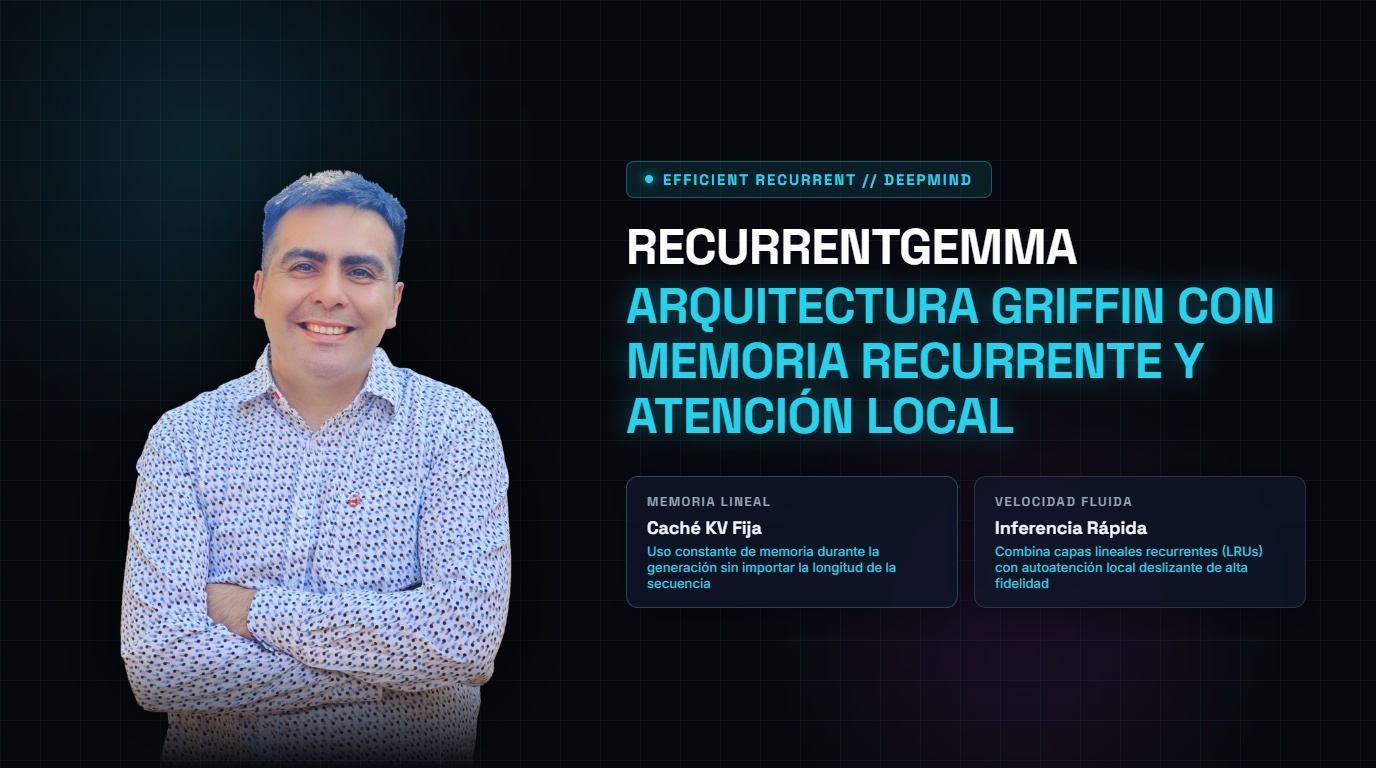 Google DeepMind Presenta RecurrentGemma: Modelos Basados en Griffin que Combinan Redes Recurrentes y Atención LocalGoogle DeepMind presenta RecurrentGemma, modelos basados en Griffin que combinan redes recurrentes y atención local con memoria fija en inferencia.Leer análisis completo