Noticias IA · Modelos en el Borde, Inferencia Local y Familia Ministral
Edición: Álvaro MaureiraFecha: 2026-11-02Fuente: Mistral AI Engineering Team
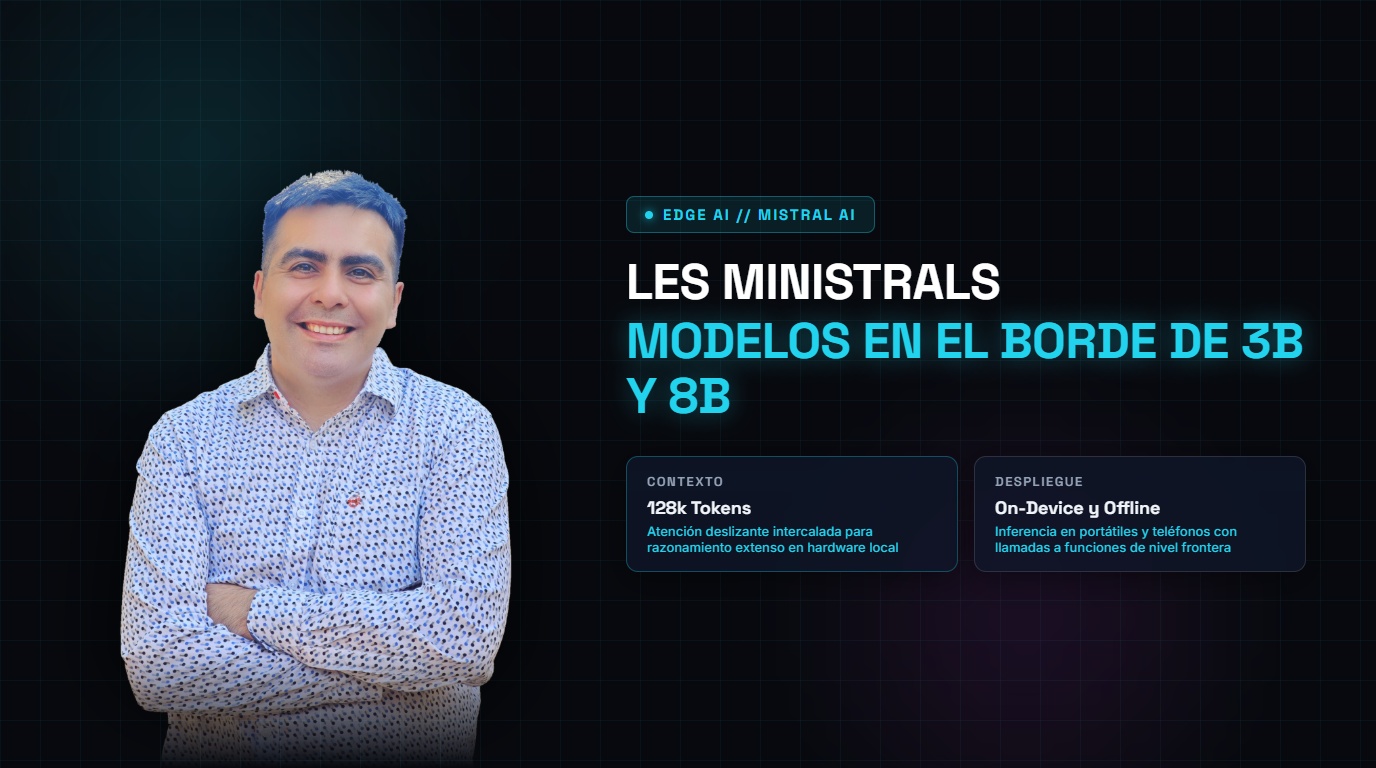
Mistral AI presentó Les Ministrals, una nueva categoría de modelos de lenguaje compactos de última generación integrados por Ministral 3B y Ministral 8B, optimizados específicamente para inferencia local en el borde (edge computing) y despliegue en dispositivos autónomos sin conexión constante a la red. Con soporte para una extensa ventana de contexto de hasta 128.000 tokens y un diseño de atención deslizante intercalada, los modelos Ministral superan a modelos del doble de parámetros en pruebas de programación, seguimiento riguroso de instrucciones y llamadas a herramientas (function calling), abriendo la puerta a asistentes inteligentes privados e instantáneos en portátiles, smartphones y robots industriales.
Capítulo 01
La noticia en una frase
Mistral AI lanzó Ministral 3B y 8B, modelos ultraligeros de borde con 128k de contexto para inferencia on-device y llamadas a herramientas.
En evaluaciones estandarizadas de la industria (como MMLU, GSM8K, HumanEval y Winogrande), Ministral 3B superó a Llama 3.2 3B y Gemma 2 2.6B, mientras que Ministral 8B demostró un rendimiento superior a Llama 3.1 8B y Mistral 7B en generación de código y razonamiento contextual extenso, manteniendo una latencia por token drásticamente inferior.
Capítulo 02
El alcance que cambia la lectura
La demanda de computación de IA en el dispositivo responde a tres imperativos críticos: privacidad absoluta de los datos personales y empresariales, eliminación de la dependencia de conectividad a Internet y reducción a cero de los costes recurrentes de API en servidores centrales.
Capítulo 03
El mecanismo documentado
La arquitectura de Les Ministrals combina un tokenizador eficiente con capas de atención densa intercaladas con capas de atención de ventana deslizante (SWA). Esta hibridación reduce el tamaño del búfer KV en un factor de cuatro, permitiendo procesar contextos largos de 128k tokens en memorias RAM unificadas de dispositivos móviles sin provocar estrangulamiento térmico.
Capítulo 04
La relación entre las piezas
Los pesos de Ministral 8B están disponibles para investigación y desarrollo local, mientras que ambos modelos se ofrecen a través de la plataforma La Plateforme de Mistral AI y en hardware especializado de socios como Qualcomm, Apple y NVIDIA.
Capítulo 05
Qué capacidad se puede atribuir
Se constata una sobresaliente precisión para ejecutar agentes locales que controlan aplicaciones del sistema operativo mediante comandos JSON estructurados. No obstante, no se debe asumir que un modelo de 3B parámetros posea la amplitud enciclopédica o el vocabulario hiper-especializado de modelos de 70B o más.
Capítulo 06
La puerta de control
Los ingenieros pueden cuantizar los modelos a formatos GGUF de 4 u 8 bits para ejecutarlos con frameworks como llama.cpp, Ollama o Apple MLX con un consumo de batería mínimo.
Capítulo 07
Lo que la fuente no demuestra
Mistral AI señala que los modelos están optimizados para texto y código, por lo que el procesamiento multimodal de visión directa requiere acopladores adicionales.
Capítulo 08
Cómo probarlo sin prometer de más
Los modelos pueden probarse en La Plateforme de Mistral AI (`console.mistral.ai`) y descargarse para uso local en Hugging Face.
Capítulo 09
Veredicto editorial
Con Les Ministrals, Mistral AI demuestra que la vanguardia de la inteligencia artificial no solo se construye expandiendo clústeres gigantescos en la nube, sino comprimiendo la destreza cognitiva para que quepa en el bolsillo de cada usuario.
Fuente oficial y reporte: Mistral AI Engineering Team